



Porque é que a qualidade dos dados vai decidir o futuro da IA de produto?
A 15 de novembro de 2025, a Nature publicou um estudo que deveria ser um choque para todos os setores dependentes da IA generativa (incluindo o e-commerce).
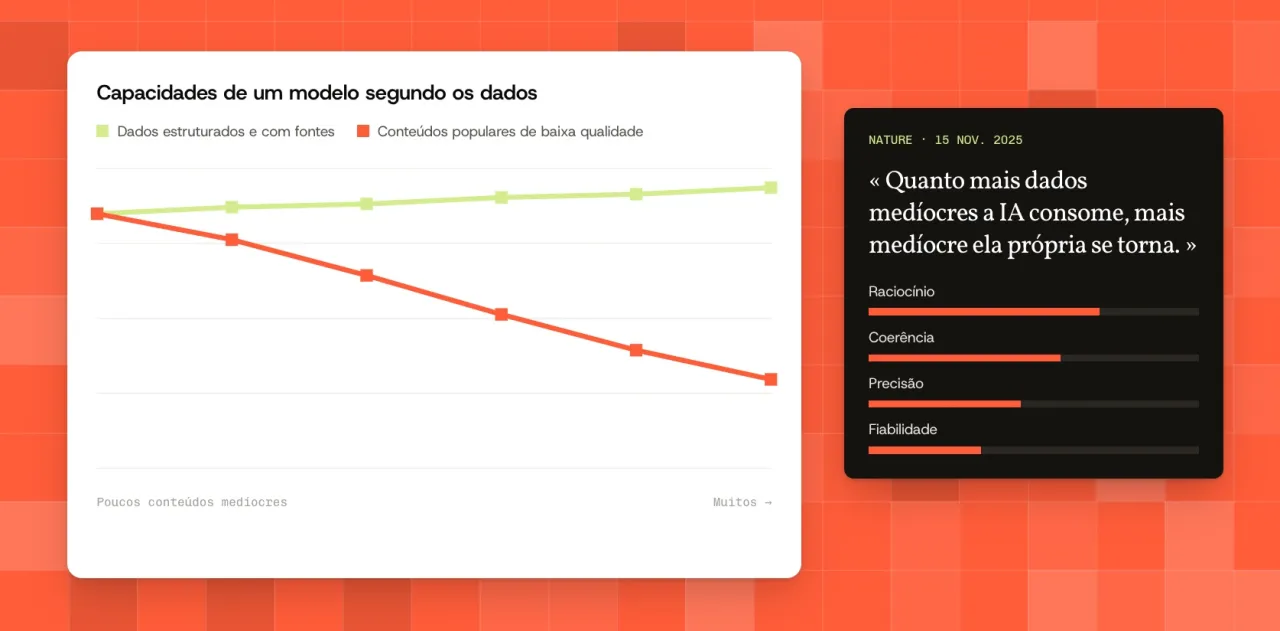
Segundo os investigadores, alimentar modelos de IA com grandes quantidades de conteúdos populares mas de baixa qualidade degrada significativamente as suas capacidades de raciocínio, de coerência, de precisão e de fiabilidade.
Por outras palavras: quanto mais dados medíocres a IA consome, mais medíocre ela própria se torna.
Esta conclusão, carregada de consequências para a indústria, abre um debate essencial: como garantir que as IA que geram os nossos conteúdos de produto, os nossos atributos, as nossas imagens ou as nossas recomendações não assentam numa base enviesada ou lacunar?
O sinal de alerta: a IA aprende… o que lhe dão
O estudo mostra que, quando os modelos são expostos a dados:
- superficiais,
- duplicados,
- inconsistentes,
- factualmente aproximados,
- ou dominados por conteúdos «de grande público» em detrimento das fontes técnicas,
o seu desempenho cai.
O efeito é cumulativo: a IA interioriza os erros, amplifica-os e transporta-os para todas as suas produções futuras.
Pensava-se que isso se corrigia com «sobretreino». O estudo demonstra o contrário: o ruído propaga-se.
Porque é que esta descoberta diz diretamente respeito ao e-commerce?
A web produz diariamente:
- descrições curtas,
- atributos em falta,
- títulos aproximados,
- páginas de fornecedores desatualizadas,
- dados de produto incoerentes de um canal para outro,
- imagens sem normas.
Este ruído é precisamente o que os modelos generalistas (ChatGPT, Claude, Gemini) absorvem quando tentam gerar ou completar uma ficha de produto.
Resultado:
➡️ alucinações sobre os materiais,
➡️ confusões entre modelos de uma mesma gama,
➡️ incompatibilidades inventadas,
➡️ atributos deduzidos em vez de verificados,
➡️ categorizações erradas.
E no retalho, uma «pequena» alucinação nunca é inofensiva: pode levar a uma má referenciação, a uma má filtragem, a uma má recomendação ou simplesmente a uma devolução.
3. A ligação direta com as IA conversacionais (GEO)
Os motores de IA, quer lhes chamemos «chatbots avançados», «agentes conversacionais» ou «motores GEO» (Generative Engine Optimization), dependem totalmente da qualidade dos dados de produto disponíveis.
Um agente de IA não adivinha. Associa. Por isso, se um produto não tiver:
- as suas dimensões,
- a sua composição,
- a sua utilização,
- os seus atributos normalizados,
- imagens legíveis,
- um texto estruturado,
então essa informação nunca poderá aparecer numa recomendação, numa comparação ou numa resposta conversacional.
Um produto mal documentado é um produto invisível na economia da IA.
É o novo paradigma do GEO: a qualidade intrínseca dos dados de produto torna-se um fator determinante da futura referenciação nos motores de IA.
O estudo confirma um ponto-chave: os dados de produto tornam-se um ativo estratégico
Durante muito tempo, o discurso dominante dizia: «A IA vai escrever, só nos resta verificar.»
O estudo lembra uma realidade muito mais exigente: a IA nunca fará melhor do que a qualidade dos dados em que assenta.
Para as marcas e os distribuidores, isto implica:
- 01Tornar fiáveis os dados dos fornecedoresformatos, normas, atributos
- 02Harmonizar os repositórios
- 03Tratar a dívida técnicaacumulada em milhares de produtos
- 04Adotar processos automáticosreproduzíveis e controláveis
- 05Garantir uma coerência totalem todos os canais
É uma mudança cultural tanto quanto técnica.
Porque é que isto valida a abordagem estruturada do conteúdo de produto?
Perante estes desafios, uma IA generalista não é a solução: alucina assim que faltam dados.
O desafio não é produzir «texto» ou «atributos», mas produzir conteúdos:
- corretos,
- completos,
- conformes,
- comprovados,
- homogéneos,
- utilizáveis,
- e prontos para todas as integrações.
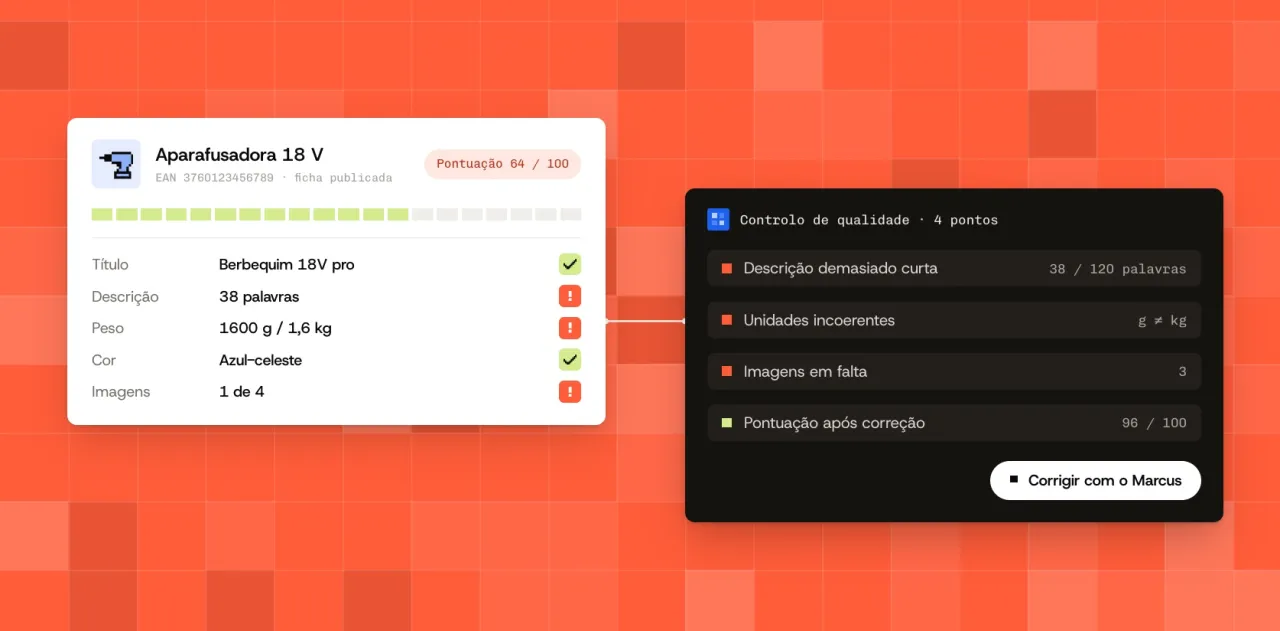
É exatamente esse o papel de uma abordagem especializada: ingerir os ficheiros dos fornecedores, detetar os erros, harmonizar os atributos, cruzar as fontes fiáveis, reconstruir um repositório e só depois gerar de forma automática e rigorosa.
No novo panorama da IA, esta abordagem já não é um conforto: torna-se a única forma de tirar verdadeiro partido da IA sem sofrer os seus desvios.
A batalha da qualidade começa agora…
Este estudo é um ponto de viragem. Porque diz claramente que:
➡️ a qualidade dos dados vai determinar a qualidade das IA,
➡️ a batalha do SEO torna-se a batalha do GEO,
➡️ os motores de IA vão privilegiar os produtos perfeitamente descritos,
➡️ o enriquecimento de produto já não deve ser artesanal, mas sistémico.
As empresas que tratarem agora a sua dívida de conteúdo vão ganhar vários anos de avanço. As outras vão deixar as IA «adivinhar»… e, portanto, enganar-se.
 Marcus




 Amazon