



Miksi datan laatu ratkaisee tuotetekoälyn tulevaisuuden?
Nature julkaisi 15. marraskuuta 2025 tutkimuksen, jonka pitäisi herättää kaikki generatiivisesta tekoälystä riippuvaiset alat (myös verkkokauppa).
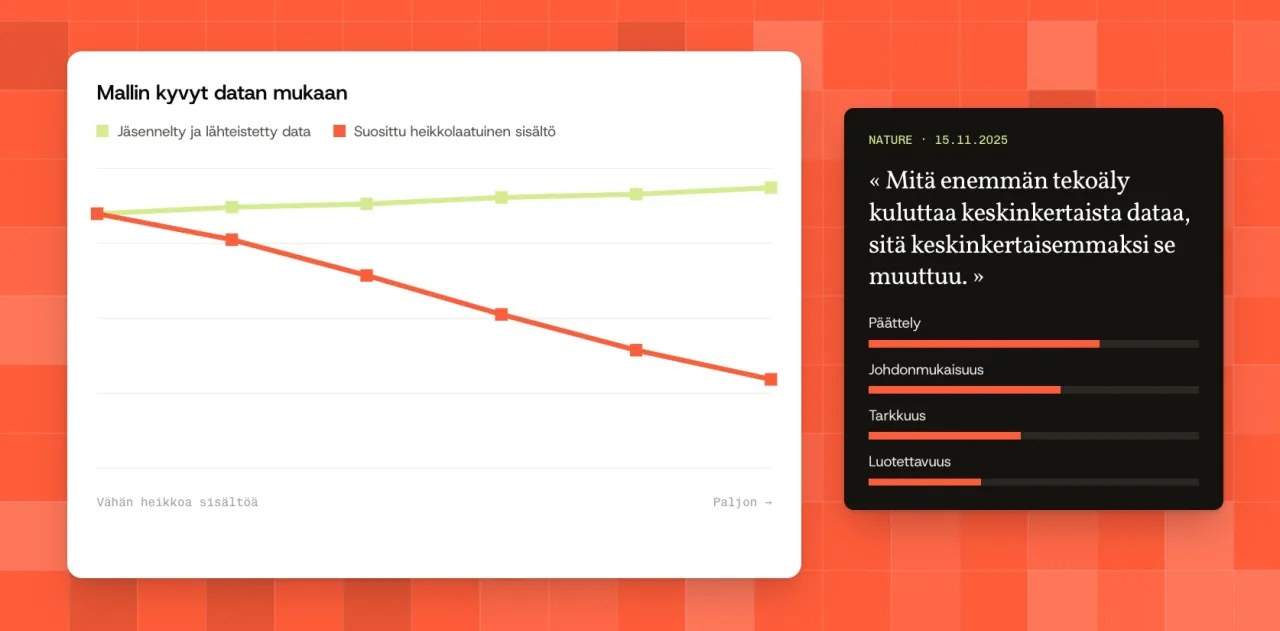
Tutkijoiden mukaan tekoälymallien ruokkiminen suurilla määrillä suosittua mutta heikkolaatuista sisältöä heikentää merkittävästi niiden päättelykykyä, johdonmukaisuutta, tarkkuutta ja luotettavuutta.
Toisin sanoen: mitä enemmän tekoäly kuluttaa keskinkertaista dataa, sitä keskinkertaisemmaksi se itse muuttuu.
Tämä johtopäätös, jolla on suuri merkitys alalle, avaa olennaisen keskustelun: miten varmistetaan, etteivät tuotesisältöjämme, attribuuttejamme, kuviamme tai suosituksiamme generoivat tekoälyt nojaa vinoutuneeseen tai puutteelliseen perustaan?
Hälytysmerkki: tekoäly oppii… sen, mitä sille annetaan
Tutkimus osoittaa, että kun mallit altistetaan datalle, joka on:
- pinnallista,
- monistettua,
- epäjohdonmukaista,
- faktoiltaan epätarkkaa,
- tai jota hallitsevat ”suuren yleisön” sisällöt teknisten lähteiden kustannuksella,
niiden suorituskyky romahtaa.
Vaikutus on kumulatiivinen: tekoäly sisäistää virheet, vahvistaa niitä ja kuljettaa niitä kaikkiin tuleviin tuotoksiinsa.
Luultiin, että tämän voisi korjata ”ylikouluttamalla”. Tutkimus osoittaa päinvastaista: kohina leviää.
Miksi tämä löydös koskee suoraan verkkokauppaa?
Verkko tuottaa päivittäin:
- lyhyitä kuvauksia,
- puuttuvia attribuutteja,
- epätarkkoja otsikoita,
- vanhentuneita toimittajasivuja,
- kanavasta toiseen epäjohdonmukaisia tuotetietoja,
- standardoimattomia kuvia.
Juuri tätä kohinaa yleiskäyttöiset mallit (ChatGPT, Claude, Gemini) imevät itseensä, kun ne yrittävät generoida tai täydentää tuotesivua.
Tulos:
➡️ hallusinaatioita materiaaleista,
➡️ sekaannuksia saman tuotesarjan mallien välillä,
➡️ keksittyjä yhteensopimattomuuksia,
➡️ attribuutteja, jotka on päätelty eikä tarkistettu,
➡️ virheellisiä luokitteluja.
Ja vähittäiskaupassa ”pieni” hallusinaatio ei ole koskaan harmiton: se voi johtaa virheelliseen listaukseen, virheelliseen suodatukseen, virheelliseen suositukseen tai yksinkertaisesti asiakaspalautukseen.
3. Suora yhteys keskusteleviin tekoälyihin (GEO)
Tekoälyhakukoneet, kutsuttiinpa niitä ”edistyneiksi chatboteiksi”, ”keskusteleviksi agenteiksi” tai ”GEO-hakukoneiksi” (Generative Engine Optimization), nojaavat täysin saatavilla olevien tuotetietojen laatuun.
Tekoälyagentti ei arvaa. Se yhdistää. Jos tuotteelta siis puuttuvat:
- mitat,
- koostumus,
- käyttötarkoitus,
- standardoidut attribuutit,
- luettavat kuvat,
- jäsennelty teksti,
nämä tiedot eivät voi koskaan näkyä suosituksessa, vertailussa tai keskustelun vastauksessa.
Huonosti dokumentoitu tuote on näkymätön tekoälytaloudessa.
Tämä on GEO:n uusi paradigma: tuotetietojen sisäisestä laadusta tulee ratkaiseva tekijä tulevassa näkyvyydessä tekoälyhakukoneissa.
Tutkimus vahvistaa keskeisen asian: tuotetiedosta tulee strateginen omaisuuserä
Pitkään vallitseva puhe kuului: ”Tekoäly kirjoittaa, meidän tarvitsee vain tarkistaa.”
Tutkimus muistuttaa paljon vaativammasta todellisuudesta: tekoäly ei koskaan suoriudu paremmin kuin sen pohjana olevan datan laatu sallii.
Brändeille ja jälleenmyyjille tämä tarkoittaa:
- 01Toimittajatietojen luotettavuuden parantaminenmuodot, standardit, attribuutit
- 02Viitetietojen yhdenmukaistaminen
- 03Teknisen velan käsittelyjoka on kertynyt tuhansiin tuotteisiin
- 04Automaattisten prosessien käyttöönottotoistettavien ja hallittavien
- 05Täydellisen johdonmukaisuuden varmistaminenkaikissa kanavissa
Tämä on yhtä lailla kulttuurinen kuin tekninen muutos.
Miksi tämä vahvistaa jäsennellyn lähestymistavan tuotesisältöön?
Näiden haasteiden edessä yleiskäyttöinen tekoäly ei ole ratkaisu: se hallusinoi heti, kun tietoa puuttuu.
Tavoitteena ei ole tuottaa ”tekstiä” tai ”attribuutteja”, vaan sisältöjä, jotka ovat:
- oikeita,
- kattavia,
- vaatimustenmukaisia,
- todennettuja,
- yhtenäisiä,
- hyödynnettäviä,
- ja valmiita kaikkiin integraatioihin.
Juuri tämä on erikoistuneen lähestymistavan tehtävä: ottaa vastaan toimittajatiedostot, tunnistaa virheet, yhdenmukaistaa attribuutit, ristiintarkistaa luotettavat lähteet, rakentaa viitetietokanta uudelleen ja vasta sitten generoida automaattisesti ja siististi.
Uudessa tekoälymaisemassa tämä lähestymistapa ei ole enää mukavuus: siitä tulee ainoa tapa hyödyntää tekoälyä todella kärsimättä sen lieveilmiöistä.
Laadun taistelu alkaa nyt…
Tämä tutkimus on käännekohta. Koska se sanoo selvästi, että:
➡️ datan laatu ratkaisee tekoälyn laadun,
➡️ SEO-taistelusta tulee GEO-taistelu,
➡️ tekoälyhakukoneet suosivat täydellisesti kuvattuja tuotteita,
➡️ tuotteiden rikastus ei saa enää olla käsityötä, vaan järjestelmällistä.
Yritykset, jotka hoitavat sisältövelkansa nyt, saavat usean vuoden etumatkan. Muut antavat tekoälyjen ”arvata”… ja siis erehtyä.
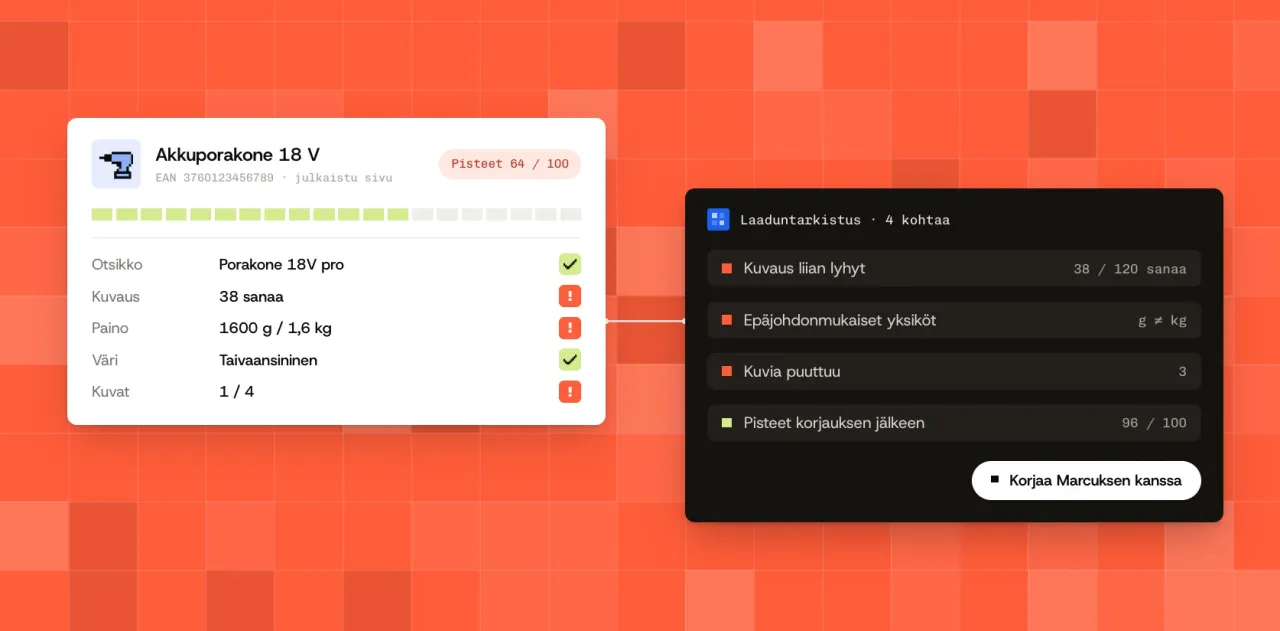
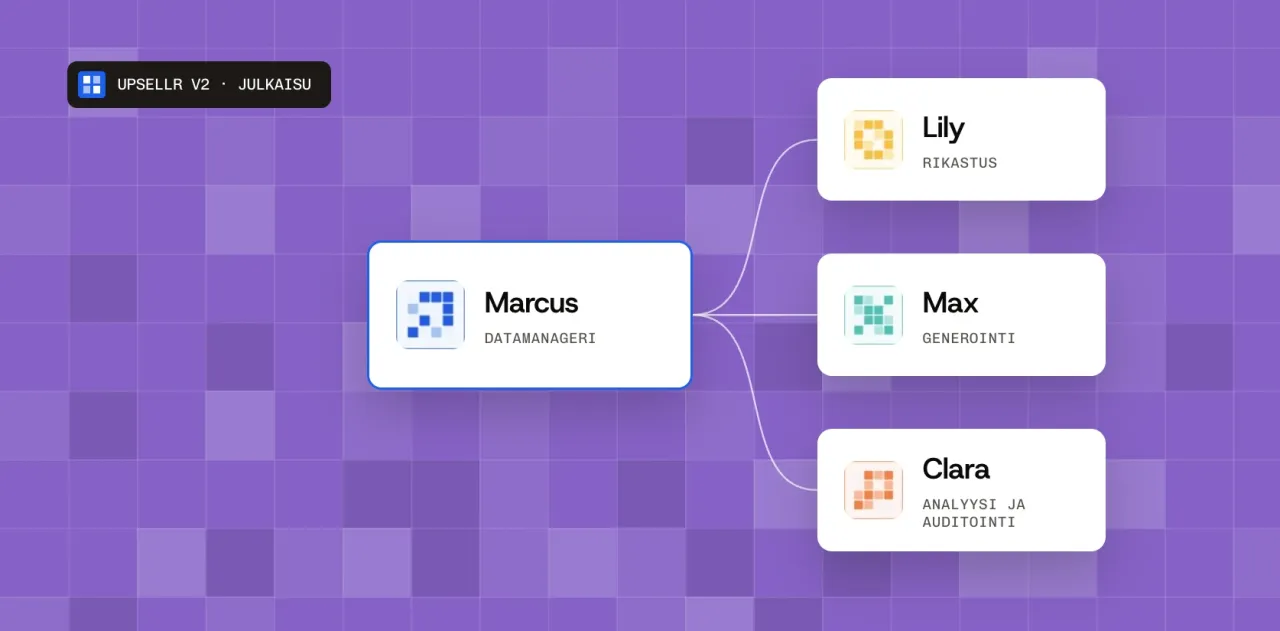
 Marcus




 Amazon