



Waarom datakwaliteit de toekomst van product-AI zal bepalen
Op 15 november 2025 publiceerde Nature een studie die als een schok zou moeten aankomen in alle sectoren die afhangen van generatieve AI (e-commerce inbegrepen).
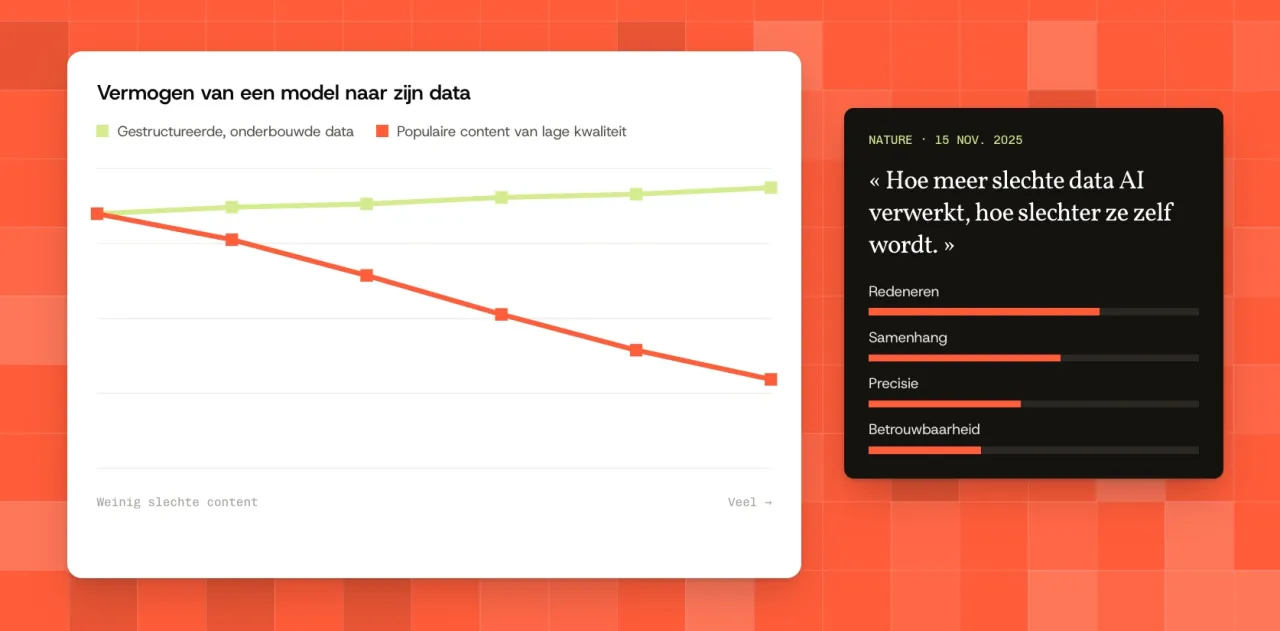
Volgens de onderzoekers tast het voeden van AI-modellen met grote hoeveelheden populaire maar kwalitatief zwakke content hun vermogen tot redeneren, hun samenhang, hun precisie en hun betrouwbaarheid aanzienlijk aan.
Met andere woorden: hoe meer middelmatige data een AI verwerkt, hoe middelmatiger hij zelf wordt.
Deze conclusie, met grote gevolgen voor de sector, opent een essentieel debat: hoe garanderen we dat de AI’s die onze productcontent, onze attributen, onze beelden of onze aanbevelingen genereren niet steunen op een vertekende of gebrekkige basis?
Het alarmsignaal: AI leert… wat je hem geeft
De studie toont aan dat wanneer modellen worden blootgesteld aan data die:
- oppervlakkig zijn,
- gedupliceerd,
- inconsistent,
- feitelijk onnauwkeurig,
- of gedomineerd door content voor het “grote publiek” ten koste van technische bronnen,
hun prestaties dalen.
Het effect is cumulatief: de AI neemt de fouten over, versterkt ze en draagt ze mee in al zijn toekomstige output.
Men dacht dit op te lossen door te “overtrainen”. De studie toont het tegendeel aan: de ruis verspreidt zich.
Waarom deze ontdekking e-commerce rechtstreeks aangaat
Het web produceert dagelijks:
- korte beschrijvingen,
- ontbrekende attributen,
- vage titels,
- verouderde leverancierspagina’s,
- productdata die van kanaal tot kanaal inconsistent zijn,
- niet-gestandaardiseerde beelden.
Die ruis is precies wat generalistische modellen (ChatGPT, Claude, Gemini) opnemen wanneer ze een productpagina proberen te genereren of aan te vullen.
Resultaat:
➡️ hallucinaties over materialen,
➡️ verwarring tussen modellen uit dezelfde productlijn,
➡️ verzonnen incompatibiliteiten,
➡️ attributen die worden afgeleid in plaats van gecontroleerd,
➡️ foute categoriseringen.
En in retail is een “kleine” hallucinatie nooit onschuldig: ze kan leiden tot een verkeerde vindbaarheid, een verkeerde filtering, een verkeerde aanbeveling of gewoonweg een retour.
3. Het directe verband met conversationele AI (GEO)
AI-engines, of je ze nu “geavanceerde chatbots”, “conversationele agents” of “GEO-engines” (Generative Engine Optimization) noemt, steunen volledig op de kwaliteit van de beschikbare productdata.
Een AI-agent raadt niet. Hij legt verbanden. Dus als een product niet beschikt over:
- zijn afmetingen,
- zijn samenstelling,
- zijn gebruik,
- zijn genormaliseerde attributen,
- leesbare beelden,
- een gestructureerde tekst,
dan kan die informatie nooit verschijnen in een aanbeveling, een vergelijking of een conversationeel antwoord.
Een slecht gedocumenteerd product is onzichtbaar in de AI-economie.
Dat is het nieuwe paradigma van GEO: de intrinsieke kwaliteit van productdata wordt bepalend voor de toekomstige vindbaarheid in AI-engines.
De studie bevestigt een kernpunt: productdata wordt een strategische asset
Lange tijd luidde het dominante discours: “AI gaat schrijven, wij hoeven alleen nog te controleren.”
De studie herinnert aan een veel veeleisendere realiteit: AI zal nooit beter presteren dan de kwaliteit van de data waarop hij steunt.
Voor merken en distributeurs betekent dit:
- 01Leveranciersdata betrouwbaar makenformaten, normen, attributen
- 02De referentiebestanden harmoniseren
- 03De technische schuld wegwerkenopgebouwd over duizenden producten
- 04Automatische processen invoerenreproduceerbaar en controleerbaar
- 05Volledige consistentie garanderenop alle kanalen
Het is evengoed een culturele als een technische verandering.
Waarom dit de gestructureerde aanpak van productcontent bevestigt
Tegenover deze uitdagingen is een generalistische AI niet de oplossing: hij hallucineert zodra er data ontbreekt.
De uitdaging is niet om “tekst” of “attributen” te produceren, maar content die:
- juist is,
- volledig,
- conform,
- bewezen,
- homogeen,
- bruikbaar,
- en klaar voor alle integraties.
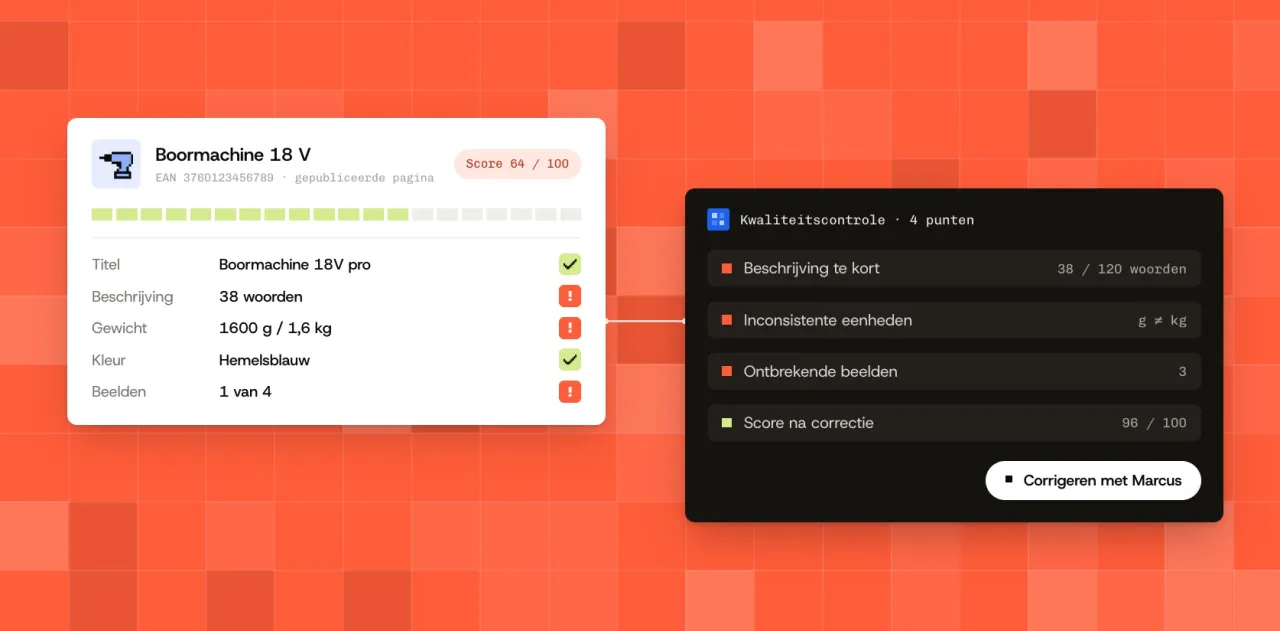
Dat is precies de rol van een gespecialiseerde aanpak: leveranciersbestanden inlezen, fouten opsporen, attributen harmoniseren, betrouwbare bronnen kruisen, een referentiebestand opbouwen, en pas daarna automatisch en zorgvuldig genereren.
In het nieuwe AI-landschap is deze aanpak geen luxe meer: ze wordt de enige manier om echt voordeel te halen uit AI zonder de ontsporingen ervan te ondergaan.
De strijd om kwaliteit begint nu…
Deze studie is een keerpunt. Omdat ze duidelijk zegt dat:
➡️ de kwaliteit van data de kwaliteit van AI zal bepalen,
➡️ de strijd om SEO de strijd om GEO wordt,
➡️ AI-engines de voorkeur zullen geven aan perfect beschreven producten,
➡️ productverrijking niet langer ambachtelijk mag zijn, maar systematisch moet worden.
De bedrijven die hun contentschuld nu aanpakken, nemen jaren voorsprong. De anderen laten AI “raden”… en dus de mist ingaan.
 Marcus




 Amazon