



Warum Datenqualität über die Zukunft der Produkt-KI entscheidet
Am 15. November 2025 veröffentlichte Nature eine Studie, die für alle Branchen, die auf generative KI setzen, ein Weckruf sein sollte, E-Commerce inklusive.
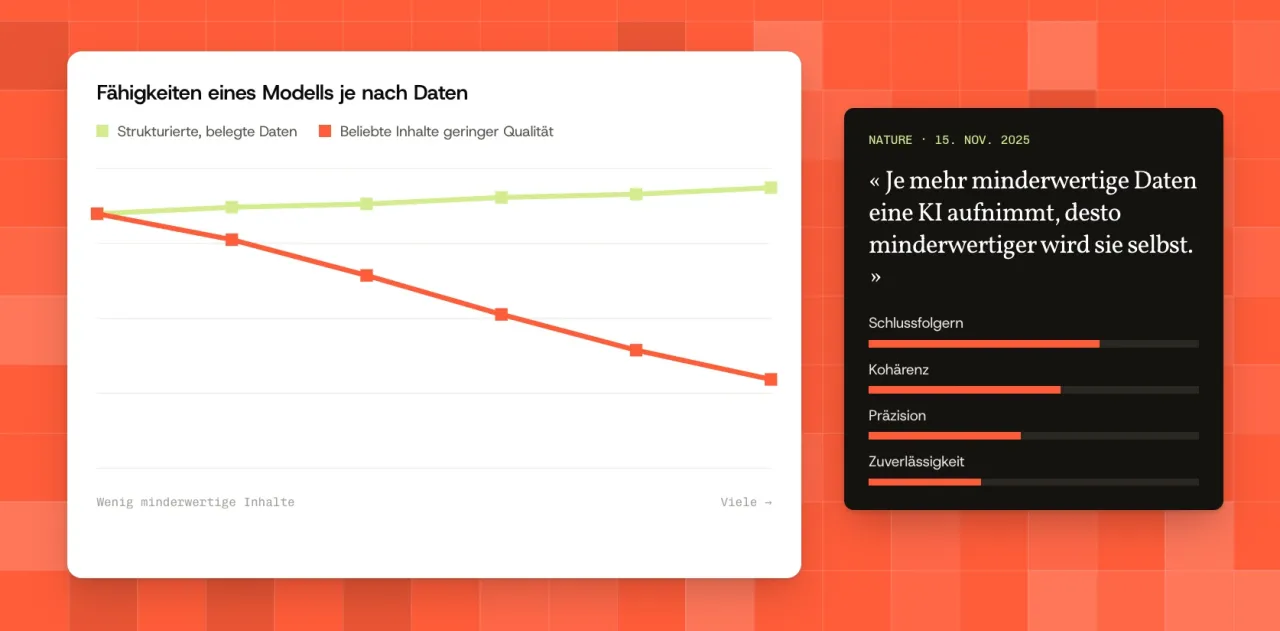
Den Forschern zufolge verschlechtert es die Fähigkeiten von KI-Modellen in Bezug auf Schlussfolgern, Kohärenz, Präzision und Zuverlässigkeit erheblich, wenn man sie mit großen Mengen populärer, aber minderwertiger Inhalte füttert.
Mit anderen Worten: Je mehr mittelmäßige Daten eine KI konsumiert, desto mittelmäßiger wird sie selbst.
Diese Schlussfolgerung, die für die Branche viel auf dem Spiel stehen lässt, eröffnet eine grundlegende Debatte: Wie lässt sich sicherstellen, dass die KI, die unsere Produktinhalte, Attribute, Bilder oder Empfehlungen generiert, nicht auf einer verzerrten oder lückenhaften Grundlage aufbaut?
Das Warnsignal: KI lernt … was man ihr gibt
Die Studie zeigt: Wenn Modelle Daten ausgesetzt sind, die
- oberflächlich,
- dupliziert,
- inkonsistent,
- sachlich ungenau,
- oder von „populären“ Inhalten zulasten technischer Quellen dominiert sind,
dann bricht ihre Leistung ein.
Der Effekt ist kumulativ: Die KI verinnerlicht die Fehler, verstärkt sie und trägt sie in alle ihre künftigen Ergebnisse.
Man glaubte, das durch „Übertraining“ korrigieren zu können. Die Studie beweist das Gegenteil: Das Rauschen pflanzt sich fort.
Warum betrifft diese Erkenntnis den E-Commerce direkt?
Das Web produziert täglich:
- kurze Beschreibungen,
- fehlende Attribute,
- ungenaue Titel,
- veraltete Lieferantenseiten,
- Produktdaten, die von Kanal zu Kanal widersprüchlich sind,
- nicht normierte Bilder.
Genau dieses Rauschen nehmen generalistische Modelle (ChatGPT, Claude, Gemini) auf, wenn sie versuchen, eine Produktseite zu generieren oder zu vervollständigen.
Das Ergebnis:
➡️ Halluzinationen bei Materialien,
➡️ Verwechslungen zwischen Modellen derselben Produktreihe,
➡️ erfundene Inkompatibilitäten,
➡️ abgeleitete statt geprüfter Attribute,
➡️ falsche Kategorisierungen.
Und im Handel ist eine „kleine“ Halluzination nie harmlos: Sie kann zu einem falschen Listing, einer falschen Filterung, einer falschen Empfehlung oder ganz einfach zu einer Retoure führen.
3. Die direkte Verbindung zu konversationeller KI (GEO)
KI-Suchmaschinen, ob man sie „fortgeschrittene Chatbots“, „Konversationsagenten“ oder „GEO-Engines“ (Generative Engine Optimization) nennt, hängen vollständig von der Qualität der verfügbaren Produktdaten ab.
Ein KI-Agent rät nicht. Er verknüpft. Wenn ein Produkt also nicht
- seine Abmessungen,
- seine Zusammensetzung,
- seinen Verwendungszweck,
- seine normalisierten Attribute,
- lesbare Bilder,
- einen strukturierten Text
hat, dann können diese Informationen niemals in einer Empfehlung, einem Vergleich oder einer konversationellen Antwort erscheinen.
Ein schlecht dokumentiertes Produkt ist in der KI-Ökonomie unsichtbar.
Das ist das neue Paradigma von GEO: Die Qualität der Produktdaten selbst wird über die künftige Sichtbarkeit in KI-Suchmaschinen entscheiden.
Die Studie bestätigt einen Kernpunkt: Produktdaten werden zum strategischen Asset
Lange lautete das vorherrschende Narrativ: „Die KI schreibt, wir müssen nur noch prüfen.“
Die Studie erinnert an eine weit anspruchsvollere Realität: Eine KI wird nie besser sein als die Qualität der Daten, auf denen sie beruht.
Für Marken und Händler bedeutet das:
- 01Lieferantendaten zuverlässig machenFormate, Normen, Attribute
- 02Die Stammdaten vereinheitlichen
- 03Die technischen Altlasten abbauendie sich über Tausende Produkte angesammelt haben
- 04Automatische Prozesse einführenreproduzierbar und kontrollierbar
- 05Vollständige Konsistenz sicherstellenüber alle Kanäle hinweg
Das ist ein kultureller ebenso wie ein technischer Wandel.
Warum bestätigt das den strukturierten Ansatz für Produktinhalte?
Angesichts dieser Herausforderungen ist eine generalistische KI nicht die Lösung: Sie halluziniert, sobald Daten fehlen.
Es geht nicht darum, „Text“ oder „Attribute“ zu produzieren, sondern Inhalte, die
- richtig,
- vollständig,
- konform,
- belegt,
- einheitlich,
- nutzbar
- und bereit für alle Integrationen sind.
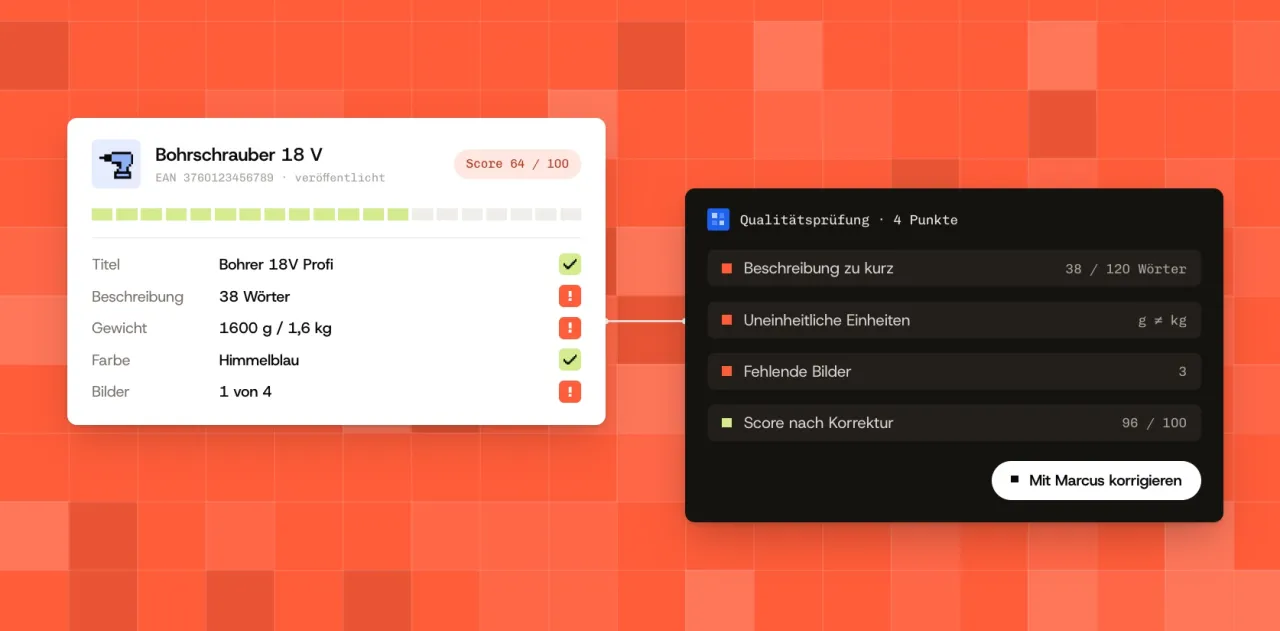
Genau das ist die Rolle eines spezialisierten Ansatzes: Lieferantendateien einlesen, Fehler erkennen, Attribute vereinheitlichen, verlässliche Quellen abgleichen, einen Stammdatenbestand neu aufbauen und erst danach automatisch und sauber generieren.
In der neuen KI-Landschaft ist dieser Ansatz kein Komfort mehr: Er wird zum einzigen Weg, KI wirklich zu nutzen, ohne unter ihren Fehlentwicklungen zu leiden.
Der Kampf um Qualität beginnt jetzt …
Diese Studie ist ein Wendepunkt. Denn sie sagt klar:
➡️ Die Qualität der Daten wird die Qualität der KI bestimmen,
➡️ der Kampf um SEO wird zum Kampf um GEO,
➡️ KI-Suchmaschinen werden perfekt beschriebene Produkte bevorzugen,
➡️ Produktanreicherung darf nicht mehr handwerklich sein, sondern muss systematisch werden.
Unternehmen, die ihre Content-Altlasten jetzt abbauen, verschaffen sich mehrere Jahre Vorsprung. Die anderen lassen die KI „raten“ … und sich damit irren.
 Marcus




 Amazon