



¿Por qué la calidad de los datos decidirá el futuro de la IA de producto?
El 15 de noviembre de 2025, Nature publicó un estudio que debería sacudir a todos los sectores que dependen de la IA generativa (e-commerce incluido).
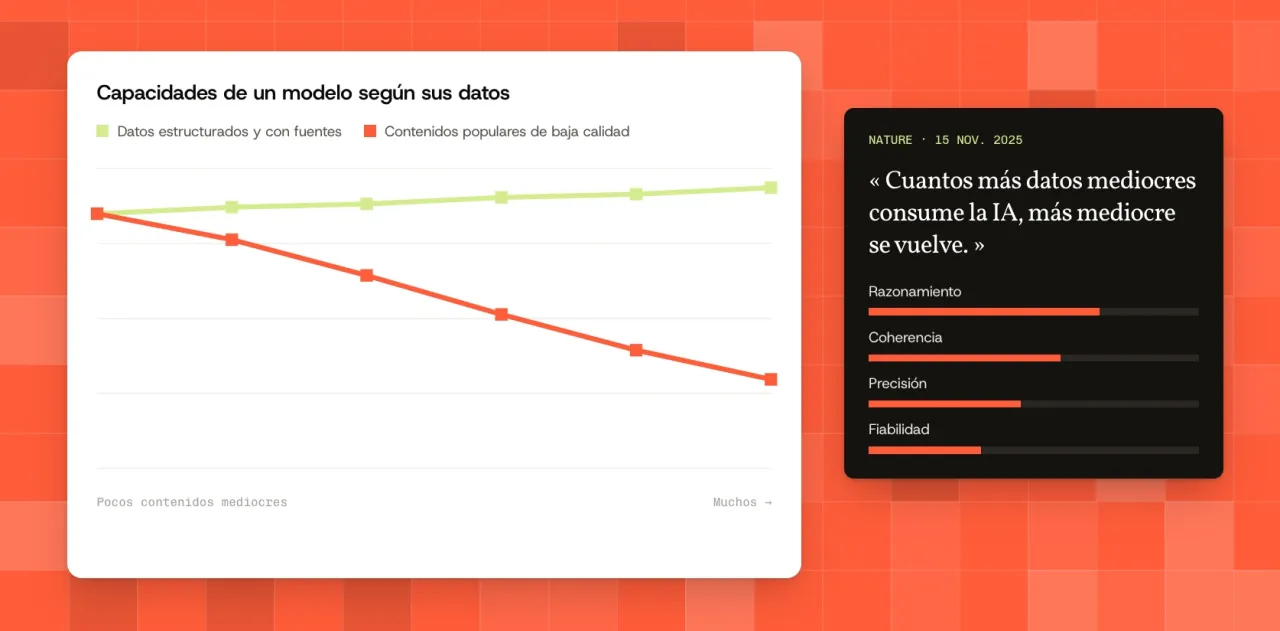
Según los investigadores, alimentar los modelos de IA con grandes cantidades de contenidos populares pero de baja calidad degrada significativamente sus capacidades de razonamiento, de coherencia, de precisión y de fiabilidad.
Dicho de otro modo: cuantos más datos mediocres consume la IA, más mediocre se vuelve ella misma.
Esta conclusión, de enorme trascendencia para la industria, abre un debate esencial: ¿cómo garantizar que las IA que generan nuestros contenidos de producto, nuestros atributos, nuestras imágenes o nuestras recomendaciones no se apoyan en una base sesgada o incompleta?
La señal de alarma: la IA aprende… lo que se le da
El estudio muestra que, cuando los modelos se exponen a datos:
- superficiales,
- duplicados,
- incoherentes,
- aproximados en los hechos,
- o dominados por contenidos «para el gran público» en detrimento de las fuentes técnicas,
su rendimiento cae.
El efecto es acumulativo: la IA interioriza los errores, los amplifica y los traslada a todas sus producciones futuras.
Se pensaba que esto se corregiría con un «sobreentrenamiento». El estudio demuestra lo contrario: el ruido se propaga.
¿Por qué este descubrimiento afecta directamente al e-commerce?
La web produce a diario:
- descripciones cortas,
- atributos que faltan,
- títulos aproximados,
- páginas de proveedores obsoletas,
- datos de producto incoherentes de un canal a otro,
- imágenes sin normalizar.
Este ruido es precisamente lo que absorben los modelos generalistas (ChatGPT, Claude, Gemini) cuando intentan generar o completar una ficha de producto.
Resultado:
➡️ alucinaciones sobre los materiales,
➡️ confusiones entre modelos de una misma gama,
➡️ incompatibilidades inventadas,
➡️ atributos deducidos en lugar de verificados,
➡️ categorizaciones erróneas.
Y en el retail, una «pequeña» alucinación nunca es inocua: puede provocar una mala referenciación, un filtrado erróneo, una recomendación equivocada o, simplemente, una devolución del cliente.
3. El vínculo directo con las IA conversacionales (GEO)
Los motores de IA, ya se les llame «chatbots avanzados», «agentes conversacionales» o «motores GEO» (Generative Engine Optimization), dependen por completo de la calidad de los datos de producto disponibles.
Un agente de IA no adivina. Asocia. Así que, si un producto no tiene:
- sus dimensiones,
- su composición,
- su uso,
- sus atributos normalizados,
- imágenes legibles,
- un texto estructurado,
esa información nunca podrá aparecer en una recomendación, una comparación o una respuesta conversacional.
Un producto mal documentado es un producto invisible en la economía de la IA.
Es el nuevo paradigma del GEO: la calidad intrínseca de los datos de producto se convierte en un factor determinante del futuro posicionamiento en los motores de IA.
El estudio confirma un punto clave: los datos de producto se convierten en un activo estratégico
Durante mucho tiempo, el discurso dominante decía: «La IA escribirá, a nosotros solo nos quedará verificar».
El estudio recuerda una realidad mucho más exigente: la IA nunca hará nada mejor que la calidad de los datos en los que se apoya.
Para las marcas y los distribuidores, esto implica:
- 01Hacer fiables los datos de los proveedoresformatos, normas, atributos
- 02Armonizar los repositorios
- 03Abordar la deuda técnicaacumulada en miles de productos
- 04Adoptar procesos automáticosreproducibles y controlables
- 05Garantizar una coherencia totalen todos los canales
Es un cambio cultural tanto como técnico.
¿Por qué esto valida el enfoque estructurado del contenido de producto?
Ante estos retos, una IA generalista no es la solución: alucina en cuanto faltan datos.
El reto no es producir «texto» o «atributos», sino producir contenidos:
- correctos,
- completos,
- conformes,
- contrastados,
- homogéneos,
- aprovechables,
- y listos para todas las integraciones.
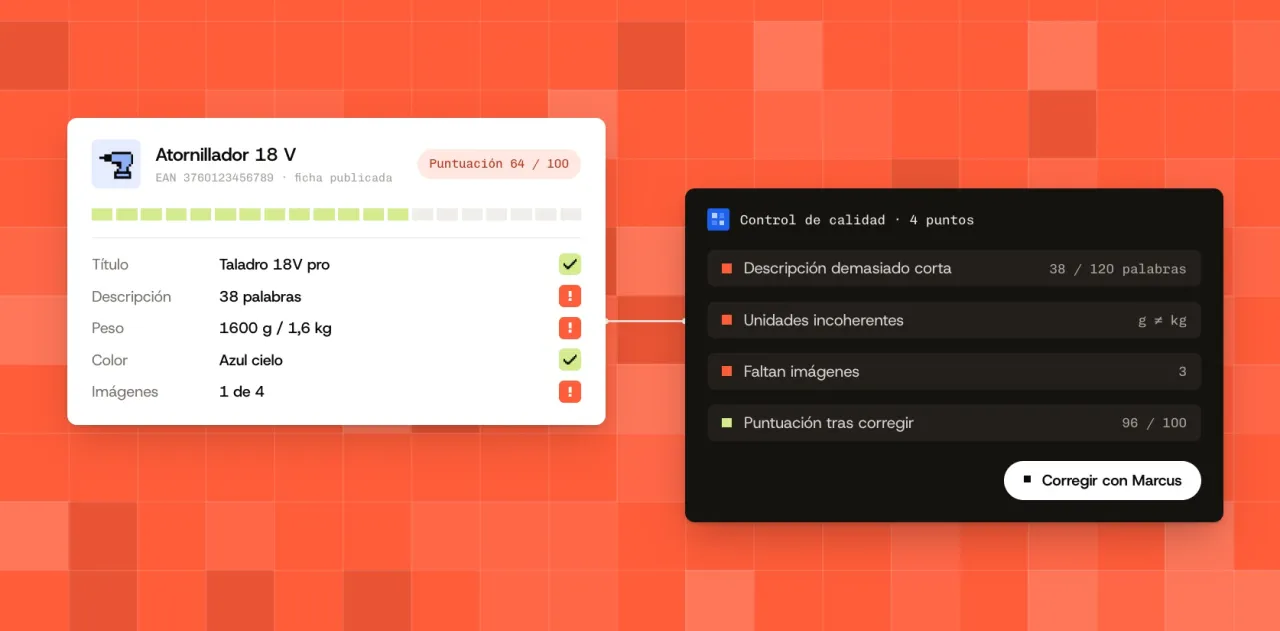
Es exactamente el papel de un enfoque especializado: ingerir los archivos de los proveedores, detectar los errores, armonizar los atributos, cruzar las fuentes fiables, reconstruir un repositorio y, solo después, generar de forma automática y limpia.
En el nuevo panorama de la IA, este enfoque ya no es una comodidad: se convierte en la única forma de aprovechar de verdad la IA sin sufrir sus desviaciones.
La batalla de la calidad empieza ahora…
Este estudio marca un punto de inflexión. Porque dice claramente que:
➡️ la calidad de los datos determinará la calidad de las IA,
➡️ la batalla del SEO se convierte en la batalla del GEO,
➡️ los motores de IA darán prioridad a los productos perfectamente descritos,
➡️ el enriquecimiento de producto ya no debe ser artesanal, sino sistémico.
Las empresas que aborden ahora su deuda de contenido tomarán varios años de ventaja. Las demás dejarán que las IA “adivinen”… y, por tanto, se equivoquen.
 Marcus




 Amazon