



Hvorfor vil datakvaliteten afgøre fremtiden for produkt-AI?
Den 15. november 2025 offentliggjorde Nature en undersøgelse, der burde virke som et chok i alle brancher, der er afhængige af generativ AI (e-handel inklusive).
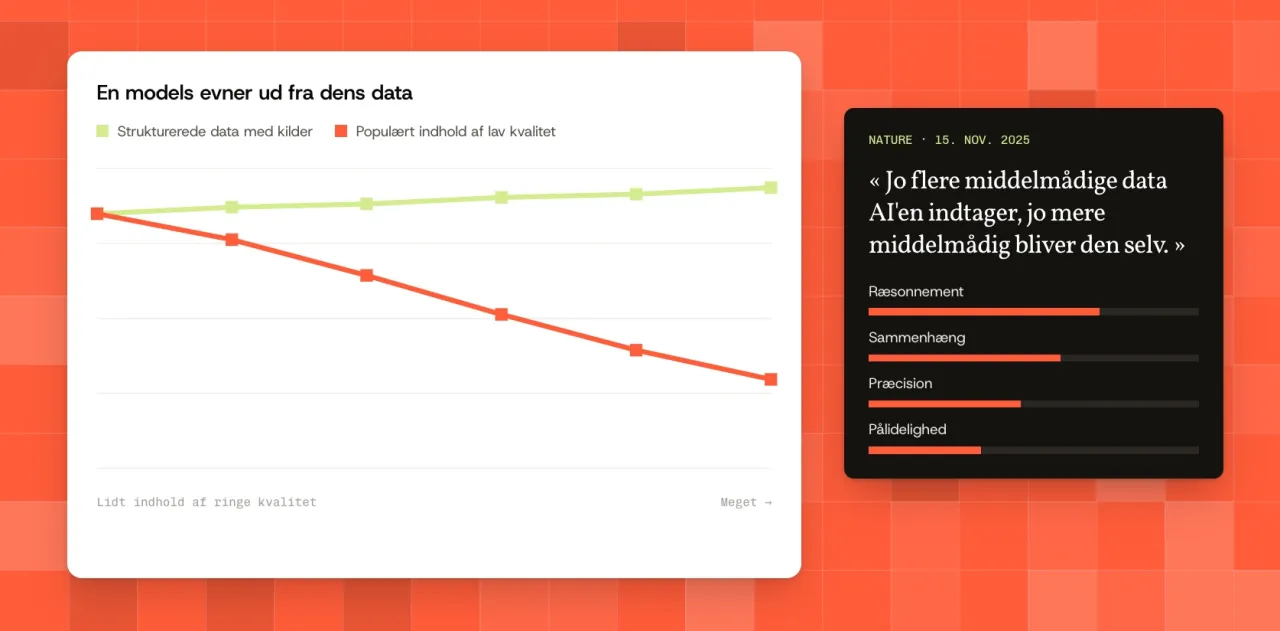
Ifølge forskerne forringer det markant AI-modellernes evne til ræsonnement, sammenhæng, præcision og pålidelighed, når de fodres med store mængder populært indhold af lav kvalitet.
Med andre ord: jo flere middelmådige data AI’en indtager, jo mere middelmådig bliver den selv.
Denne konklusion, som har store konsekvenser for branchen, åbner en afgørende debat: hvordan sikrer vi, at de AI-systemer, der genererer vores produktindhold, vores attributter, vores billeder eller vores anbefalinger, ikke bygger på et skævt eller mangelfuldt grundlag?
Advarselssignalet: AI lærer… det, man giver den
Undersøgelsen viser, at når modellerne udsættes for data, der er:
- overfladiske,
- duplikerede,
- inkonsistente,
- faktuelt upræcise,
- eller domineret af »massemarkedsindhold« på bekostning af tekniske kilder,
så falder deres præstationer.
Effekten er kumulativ: AI’en internaliserer fejlene, forstærker dem og bærer dem med sig ind i alt, hvad den producerer fremover.
Man troede, at man kunne rette det ved at »overtræne«. Undersøgelsen viser det modsatte: støjen breder sig.
Hvorfor angår denne opdagelse direkte e-handlen?
Nettet producerer dagligt:
- korte beskrivelser,
- manglende attributter,
- upræcise titler,
- forældede leverandørsider,
- produktdata, der ikke stemmer overens fra den ene kanal til den anden,
- billeder uden standarder.
Det er netop denne støj, som de generelle modeller (ChatGPT, Claude, Gemini) opsuger, når de forsøger at generere eller udfylde en produktside.
Resultatet:
➡️ hallucinationer om materialer,
➡️ forvekslinger mellem modeller i samme serie,
➡️ opfundne inkompatibiliteter,
➡️ attributter, der udledes i stedet for at blive kontrolleret,
➡️ forkerte kategoriseringer.
Og i retail er en »lille« hallucination aldrig uskyldig: den kan føre til forkert listning, forkert filtrering, en forkert anbefaling eller ganske enkelt en returnering.
3. Den direkte forbindelse til konversationel AI (GEO)
AI-motorerne, hvad enten man kalder dem »avancerede chatbots«, »konversationelle agenter« eller »GEO-motorer« (Generative Engine Optimization), hviler fuldstændig på kvaliteten af de tilgængelige produktdata.
En AI-agent gætter ikke. Den forbinder. Så hvis et produkt mangler:
- sine mål,
- sin sammensætning,
- sin anvendelse,
- sine standardiserede attributter,
- sine læsbare billeder,
- en struktureret tekst,
så kan disse oplysninger aldrig dukke op i en anbefaling, en sammenligning eller et konversationelt svar.
Et dårligt dokumenteret produkt er et usynligt produkt i AI-økonomien.
Det er GEO’s nye paradigme: produktdataenes iboende kvalitet bliver afgørende for den fremtidige synlighed i AI-motorerne.
Undersøgelsen bekræfter et nøglepunkt: produktdata bliver et strategisk aktiv
I lang tid lød den fremherskende fortælling: »AI’en skriver, vi skal bare kontrollere.«
Undersøgelsen minder os om en langt mere krævende virkelighed: AI’en bliver aldrig bedre end kvaliteten af de data, den bygger på.
For brands og forhandlere indebærer det:
- 01At gøre leverandørdataene pålideligeformater, standarder, attributter
- 02At harmonisere referencedataene
- 03At afvikle den tekniske gældder har hobet sig op over tusindvis af produkter
- 04At indføre automatiske processerder kan gentages og kontrolleres
- 05At sikre fuld sammenhængpå alle kanaler
Det er en kulturel forandring lige så meget som en teknisk.
Hvorfor bekræfter det den strukturerede tilgang til produktindhold?
Over for disse udfordringer er en generel AI ikke løsningen: den hallucinerer, så snart data mangler.
Udfordringen er ikke at producere »tekst« eller »attributter«, men at producere indhold, der er:
- korrekt,
- komplet,
- i overensstemmelse med reglerne,
- dokumenteret,
- ensartet,
- brugbart,
- og klar til alle integrationer.
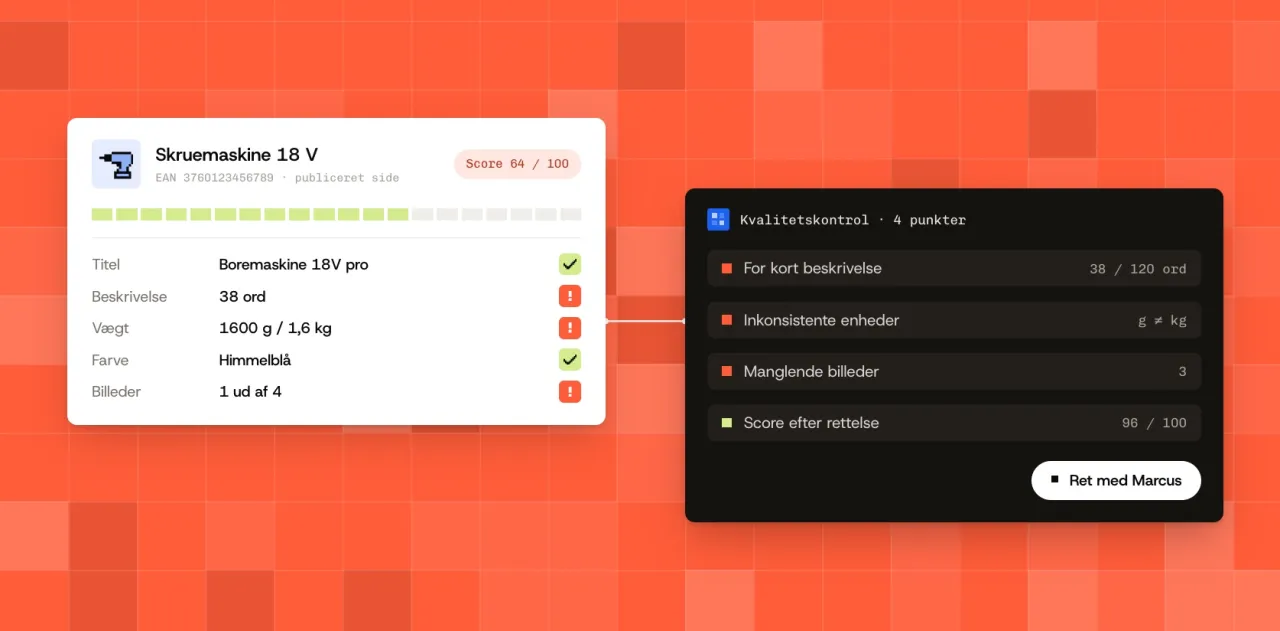
Det er præcis rollen for en specialiseret tilgang: at indlæse leverandørfilerne, finde fejlene, harmonisere attributterne, krydstjekke pålidelige kilder, genopbygge et referencegrundlag og først derefter generere automatisk og korrekt.
I det nye AI-landskab er denne tilgang ikke længere en luksus: den bliver den eneste måde at få reelt udbytte af AI på uden at lide under dens afveje.
Kampen om kvaliteten begynder nu…
Denne undersøgelse er et vendepunkt. For den siger klart, at:
➡️ datakvaliteten vil afgøre AI’ens kvalitet,
➡️ kampen om SEO bliver kampen om GEO,
➡️ AI-motorerne vil foretrække produkter, der er perfekt beskrevet,
➡️ produktberigelse ikke længere må være håndværk, men systematisk.
De virksomheder, der tager hånd om deres indholdsgæld nu, vil komme flere år foran. De andre vil lade AI’en “gætte”… og dermed tage fejl.
 Marcus




 Amazon