



Varför avgör datakvaliteten framtiden för AI inom produktdata?
Den 15 november 2025 publicerade Nature en studie som borde väcka alla branscher som är beroende av generativ AI (e-handeln inräknad).
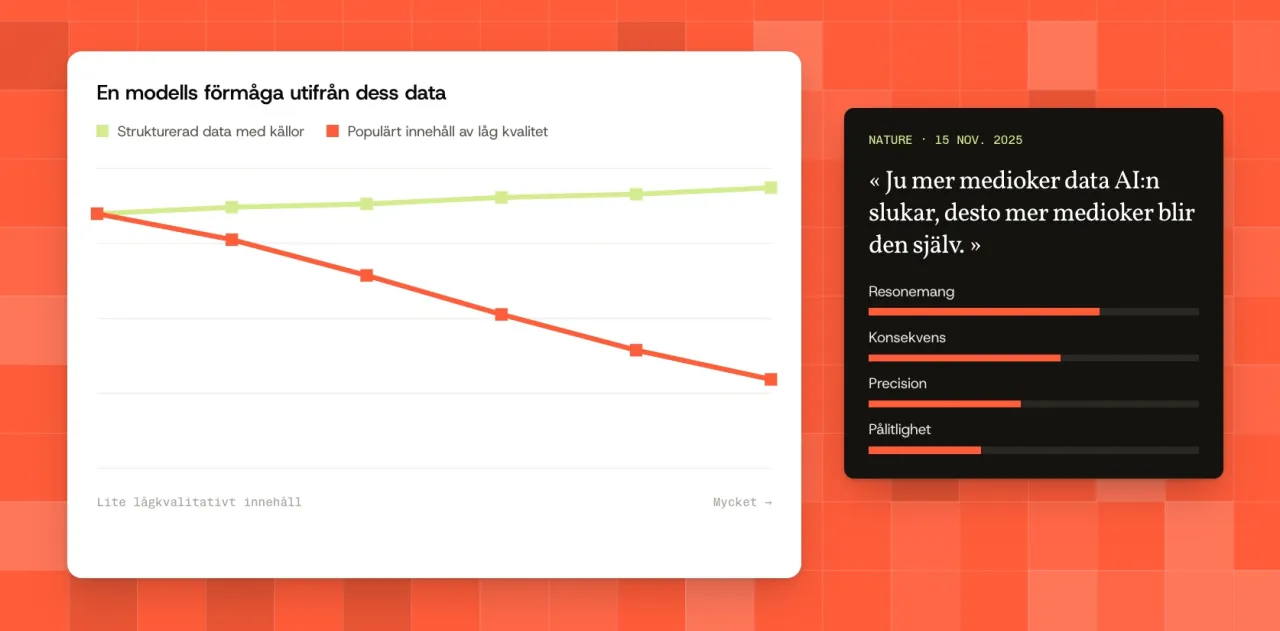
Enligt forskarna försämras AI-modellernas förmåga till resonemang, konsekvens, precision och tillförlitlighet avsevärt när de matas med stora mängder populärt men lågkvalitativt innehåll.
Med andra ord: ju mer medioker data AI:n konsumerar, desto mer medioker blir den själv.
Slutsatsen, som får stora konsekvenser för branschen, öppnar en avgörande debatt: hur säkerställer vi att de AI-system som genererar vårt produktinnehåll, våra attribut, våra bilder eller våra rekommendationer inte vilar på en skev eller bristfällig grund?
Varningssignalen: AI lär sig… det man ger den
Studien visar att när modellerna exponeras för data som är:
- ytlig,
- duplicerad,
- inkonsekvent,
- ungefärlig i sak,
- eller dominerad av innehåll för den breda allmänheten på bekostnad av tekniska källor,
så sjunker deras prestanda.
Effekten är kumulativ: AI:n tar till sig felen, förstärker dem och för dem vidare i allt den producerar framöver.
Man trodde att man kunde rätta till det genom att ”överträna”. Studien visar motsatsen: bruset sprider sig.
Varför berör upptäckten e-handeln direkt?
Webben producerar varje dag:
- korta beskrivningar,
- saknade attribut,
- ungefärliga titlar,
- inaktuella leverantörssidor,
- produktdata som inte stämmer överens från en kanal till en annan,
- bilder utan standard.
Det är precis det bruset som generella modeller (ChatGPT, Claude, Gemini) tar till sig när de försöker generera eller komplettera en produktsida.
Resultat:
➡️ hallucinationer om material,
➡️ förväxlingar mellan modeller i samma serie,
➡️ påhittade inkompatibiliteter,
➡️ attribut som härleds i stället för att kontrolleras,
➡️ felaktiga kategoriseringar.
Och inom retail är en ”liten” hallucination aldrig harmlös: den kan leda till fel listning, fel filtrering, fel rekommendation eller helt enkelt en retur.
3. Den direkta kopplingen till konversationell AI (GEO)
AI-motorerna, oavsett om man kallar dem ”avancerade chattbottar”, ”konversationella agenter” eller ”GEO-motorer” (Generative Engine Optimization), vilar helt på kvaliteten i den tillgängliga produktdatan.
En AI-agent gissar inte. Den kopplar ihop. Så om en produkt saknar:
- sina mått,
- sin sammansättning,
- sitt användningsområde,
- sina normaliserade attribut,
- läsbara bilder,
- en strukturerad text,
då kan den informationen aldrig dyka upp i en rekommendation, en jämförelse eller ett konversationellt svar.
En dåligt dokumenterad produkt är en osynlig produkt i AI-ekonomin.
Det är GEO:s nya paradigm: produktdatans inneboende kvalitet blir avgörande för framtidens synlighet i AI-motorerna.
Studien bekräftar en nyckelpunkt: produktdatan blir en strategisk tillgång
Länge löd det dominerande budskapet: ”AI:n kommer att skriva, vi behöver bara kontrollera.”
Studien påminner om en betydligt mer krävande verklighet: AI:n blir aldrig bättre än kvaliteten på den data den vilar på.
För varumärken och återförsäljare innebär det att:
- 01Göra leverantörsdatan tillförlitligformat, standarder, attribut
- 02Harmonisera referensdatan
- 03Ta itu med den tekniska skuldensom byggts upp över tusentals produkter
- 04Införa automatiska processersom går att upprepa och kontrollera
- 05Säkerställa fullständig konsekvensi alla kanaler
Det är en kulturell förändring lika mycket som en teknisk.
Varför bekräftar detta det strukturerade angreppssättet för produktinnehåll?
Inför dessa utmaningar är en generell AI inte lösningen: den hallucinerar så fort data saknas.
Utmaningen är inte att producera ”text” eller ”attribut”, utan att producera innehåll som är:
- korrekt,
- komplett,
- regelenligt,
- belagt,
- enhetligt,
- användbart,
- och redo för alla integrationer.
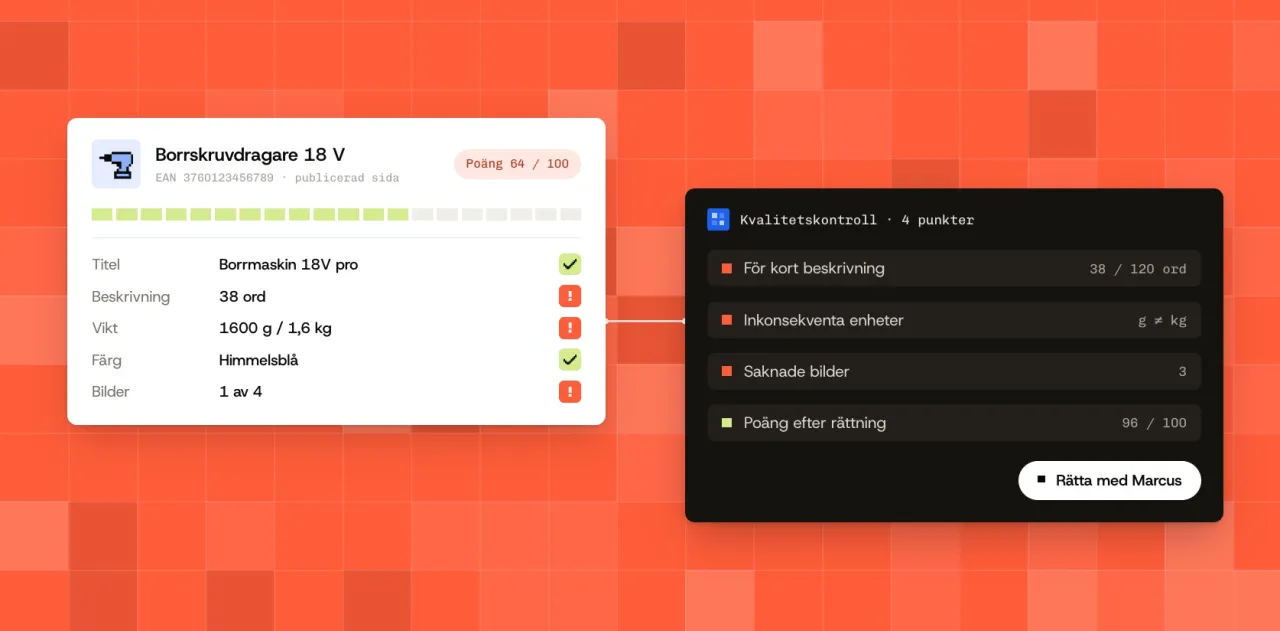
Det är precis rollen för ett specialiserat angreppssätt: läsa in leverantörsfilerna, hitta felen, harmonisera attributen, korsköra tillförlitliga källor, bygga upp ett referensregister och först därefter generera automatiskt och korrekt.
I det nya AI-landskapet är det här angreppssättet ingen bekvämlighet längre: det blir det enda sättet att verkligen dra nytta av AI utan att drabbas av dess avarter.
Kampen om kvaliteten börjar nu…
Studien är en vändpunkt. För den säger tydligt att:
➡️ datakvaliteten kommer att avgöra AI:s kvalitet,
➡️ kampen om SEO blir en kamp om GEO,
➡️ AI-motorerna kommer att gynna perfekt beskrivna produkter,
➡️ produktberikning inte längre får vara hantverk, utan måste vara systematisk.
De företag som tar itu med sin innehållsskuld nu får flera års försprång. De andra låter AI:n ”gissa”… och alltså göra fel.
 Marcus




 Amazon