



Mappatura dei dati prodotto: capire il percorso dei dati prodotto
Quando si parla di “dati prodotto”, si ha spesso l’impressione che si tratti di un blocco unico.
Quando si parla di “dati prodotto”, si ha spesso l’impressione che si tratti di un blocco unico. In realtà i dati prodotto sono un flusso, che attraversa più sistemi, più funzioni aziendali e più livelli di maturità prima di arrivare al cliente.
Per capire dove nascono gli attriti e dove l’IA cambia davvero le carte in tavola, bisogna prima mappare questo percorso.
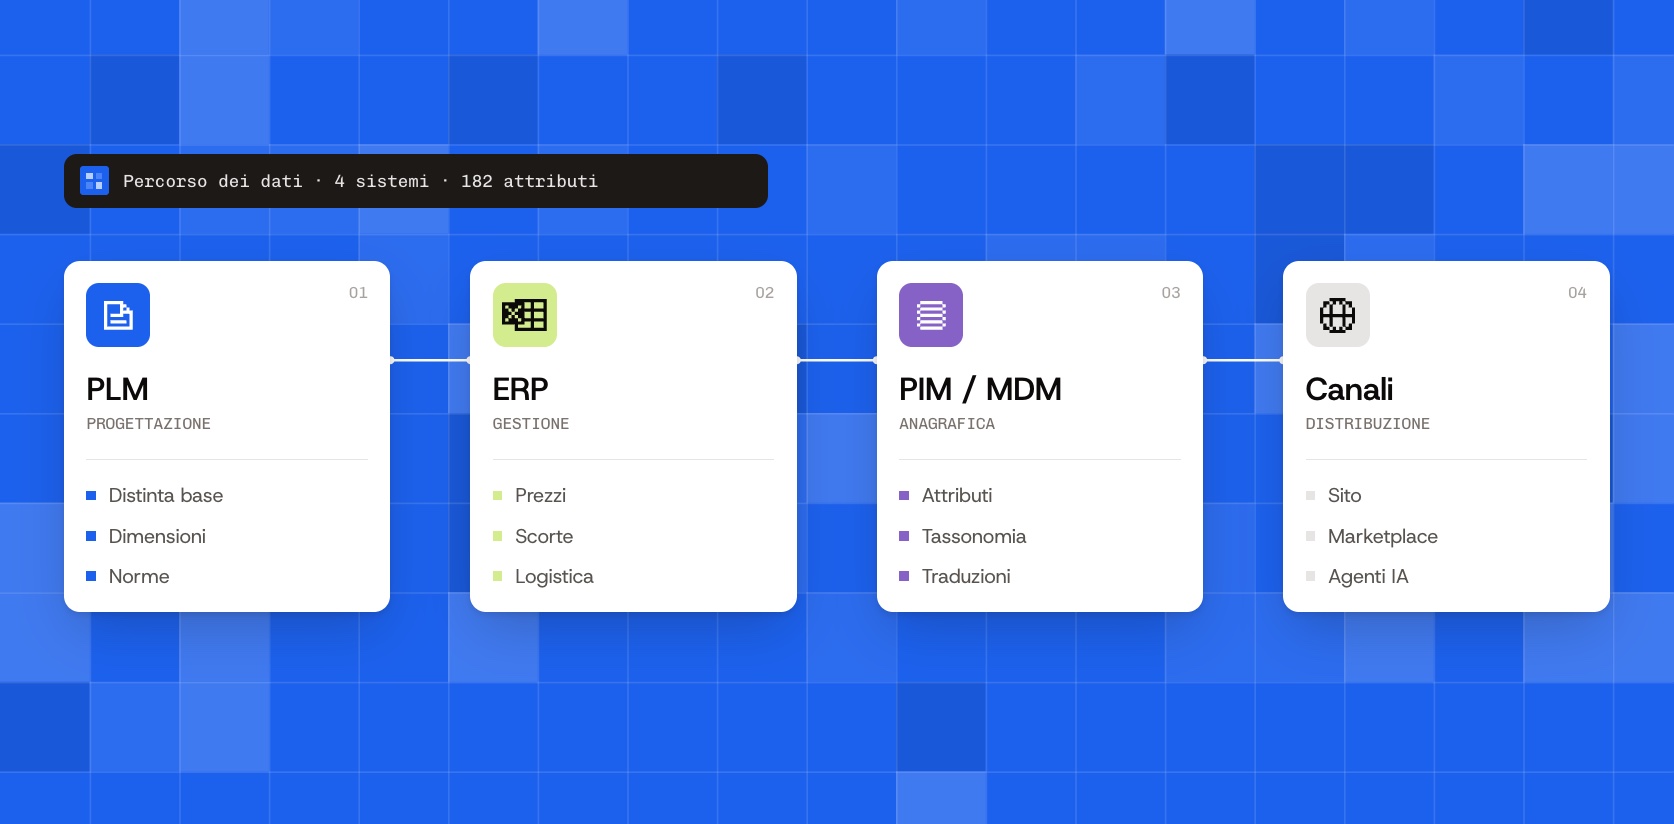
Nella maggior parte delle organizzazioni e-commerce e retail, la catena dei dati prodotto segue quattro grandi tappe, non sempre chiamate per nome, ma che si riassumono così: PLM, MDM, PIM e poi i canali di distribuzione, talvolta con l’uso di feed manager a monte
1. PLM: dove nascono i dati prodotto
Il PLM (Product Lifecycle Management) è il punto di partenza.
È qui che il prodotto viene progettato:
R&S, ingegneria, specifiche industriali, distinte base, vincoli normativi, materiali, dimensioni, standard.
👉 Qui i dati sono:
- molto ricchi
- molto precisi
- ma pensati per l’industria, non per la vendita
A questo stadio il prodotto esiste tecnicamente, ma non è ancora utilizzabile dai team e-commerce o marketing.
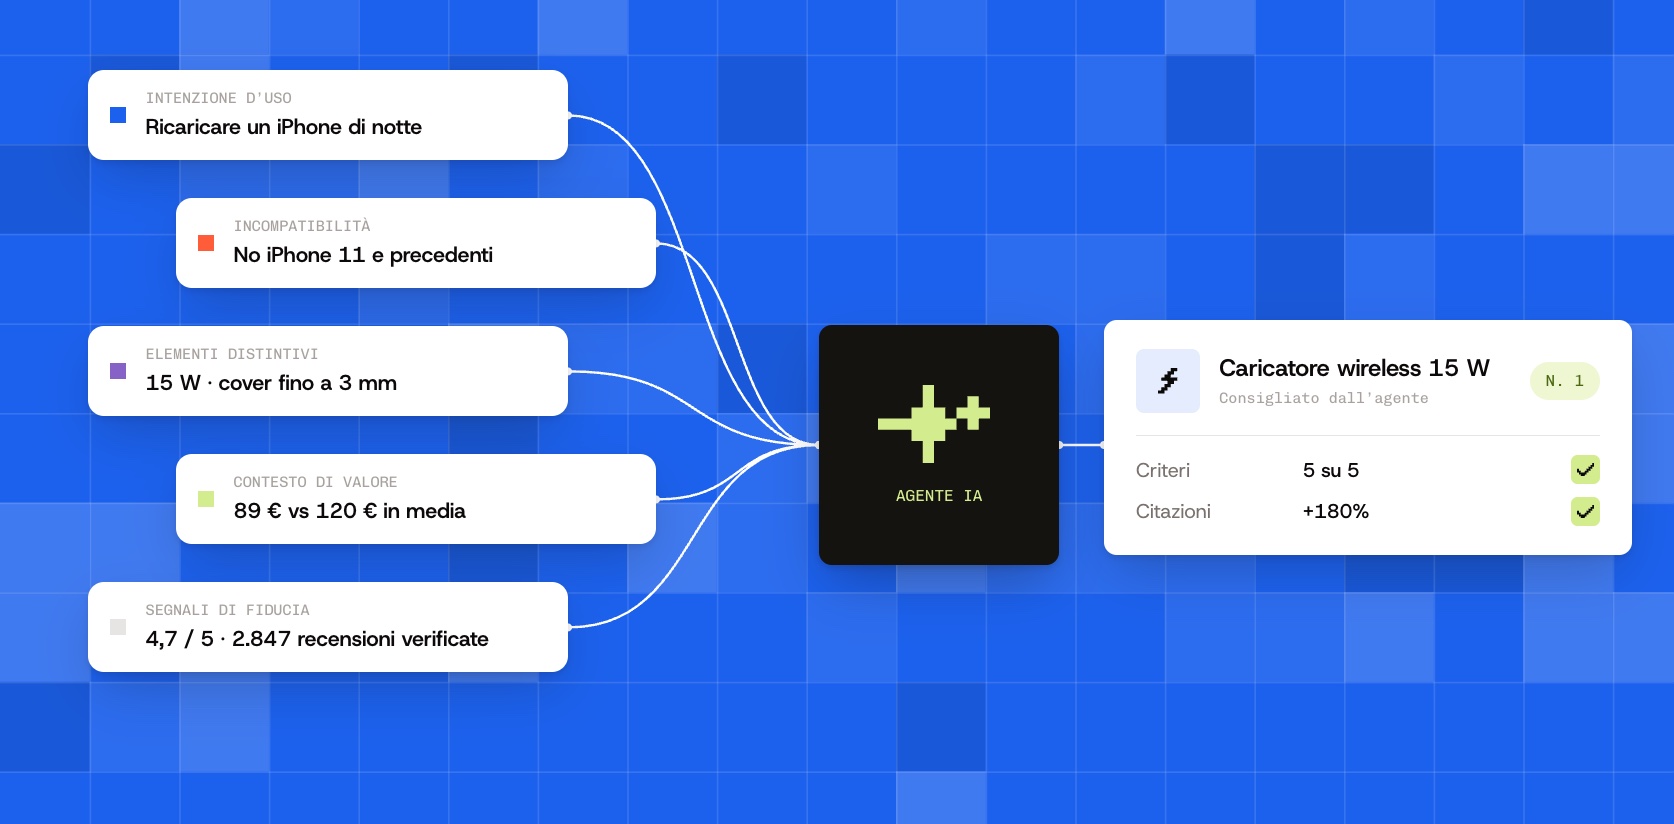
Gli agenti IA possono cominciare già qui a svolgere un ruolo discreto ma utile: estrarre, strutturare e riformulare informazioni tecniche complesse per renderle comprensibili a valle.
2. MDM: rendere affidabile e unificare
L’MDM (Master Data Management) è spesso il tassello meno visibile… eppure il più strutturante.
È la spina dorsale dei dati.
Qui si:
- armonizzano i repository di riferimento
- eliminano i duplicati
- normalizzano gli attributi
- unificano unità, valori ed etichette
- garantisce una versione unica della verità
Senza un MDM solido, ogni sistema interpreta i dati a modo suo.
Gli agenti IA sono particolarmente efficaci a questo livello per:
- individuare incoerenze e anomalie
- riconciliare fonti eterogenee
- arricchire automaticamente i campi mancanti
- controllare la qualità dei dati in modo continuo
È una tappa chiave: prima di accelerare con l’IA, bisogna rendere i dati affidabili.
3. PIM: rendere i dati utilizzabili commercialmente
Il PIM (Product Information Management) è la cabina di pilotaggio dell’e-commerce.
È qui che i dati diventano:
- descrittivi
- comprensibili
- confrontabili
- vendibili
Descrizioni prodotto, attributi di marketing, SEO, traduzioni, varianti, regole per canale…
È anche qui che il carico operativo esplode quando i cataloghi superano qualche centinaio o addirittura qualche migliaio di prodotti.
Gli agenti IA trasformano profondamente questa tappa:
- generazione di contenuti coerenti a partire da dati strutturati
- arricchimento automatico degli attributi e delle immagini
- adattamento dei contenuti in base a canali, lingue o mercati
- controlli di qualità prima della pubblicazione
Non si parla più solo di “produrre più in fretta”, ma di mantenere la qualità su larga scala.
4. Canali: dove i dati vengono consumati
Ultima tappa: i canali.
Siti e-commerce, marketplace, app, cataloghi cartacei, feed dei partner… E ora anche motori di ricerca arricchiti e IA conversazionali.
Ogni canale impone:
- i suoi formati
- le sue regole
- i suoi requisiti di strutturazione
A questo livello, gli agenti IA:
- trasformano i dati per ogni canale
- automatizzano l’aggiornamento dei feed
- verificano la conformità
- alimentano motori capaci di raccomandare, confrontare e rispondere a intenzioni d’uso
👉 La qualità dei dati prodotto determina direttamente visibilità, conversione e fiducia.
5. E i feed manager in tutto questo?
Tra il PIM e i canali, molte organizzazioni si affidano oggi a feed manager (Channable, Lengow, Feed Manager, ecc.).
Il loro ruolo è chiaro: adattare, trasformare e distribuire i dati prodotto verso una moltitudine di piattaforme: marketplace, comparatori, social commerce, partner, concessionarie pubblicitarie e ora anche motori di IA.
Svolgono un ruolo chiave per:
- mappare gli attributi sugli schemi richiesti da ogni canale
- applicare regole di trasformazione e di priorità
- gestire varianti di feed su larga scala
- mantenere una distribuzione continua e controllata
Ma i feed manager hanno un limite strutturale: non creano i dati. Li orchestrano.
Se i dati in ingresso sono incompleti, incoerenti o strutturati male, il feed manager non fa altro che riconciliare approssimazioni.
È qui che l’integrazione con agenti IA a monte diventa critica.
Agenti posizionati tra MDM e PIM, e poi tra PIM e feed manager, permettono di:
- arricchire gli attributi prima della distribuzione
- rendere affidabili i valori chiave (unità, compatibilità, utilizzi)
- preparare feed “IA-ready”, coerenti e utilizzabili da tutti i canali
In un mondo in cui i canali si moltiplicano e i motori di IA diventano essi stessi consumatori di feed, il feed manager resta indispensabile, ma dipende più che mai dalla qualità dei dati a monte.
👉 La performance non si gioca più nella trasformazione finale, ma nella capacità di fornire dati puliti, strutturati e intenzionali prima della distribuzione.
In sintesi: una catena continua, non dei silos
Si può riassumere questa mappatura in modo semplice:
- PLM: fabbricare il prodotto
- MDM: rendere affidabili i dati
- PIM: valorizzare il prodotto
- Canali (con o senza feed manager): distribuire e vendere
Ciò che l’IA rivela oggi è che i dati prodotto sono diventati il principale fattore limitante della performance e-commerce.
Gli agenti IA non sostituiscono questi tasselli.
Li attraversano.
Li collegano.
E soprattutto ne rendono subito visibili le debolezze.
La vera domanda quindi non è più solo tecnologica.
👉 A che punto sono i tuoi dati prodotto in questa catena?
👉 E in quale momento diventano una leva… o un freno?
È a questa condizione che l’IA può creare davvero valore, in modo duraturo.
 Marcus




 Amazon