



Kartläggning av produktdata: förstå produktdatans väg
När man talar om ”produktdata” får man ofta intrycket att det handlar om ett enda block.
När man talar om ”produktdata” får man ofta intrycket att det handlar om ett enda block. I verkligheten är produktdata ett flöde som passerar flera system, flera yrkesroller och flera mognadsnivåer innan det når kunden.
För att förstå var friktionen uppstår och var AI verkligen förändrar spelplanen måste man först kartlägga den resan.
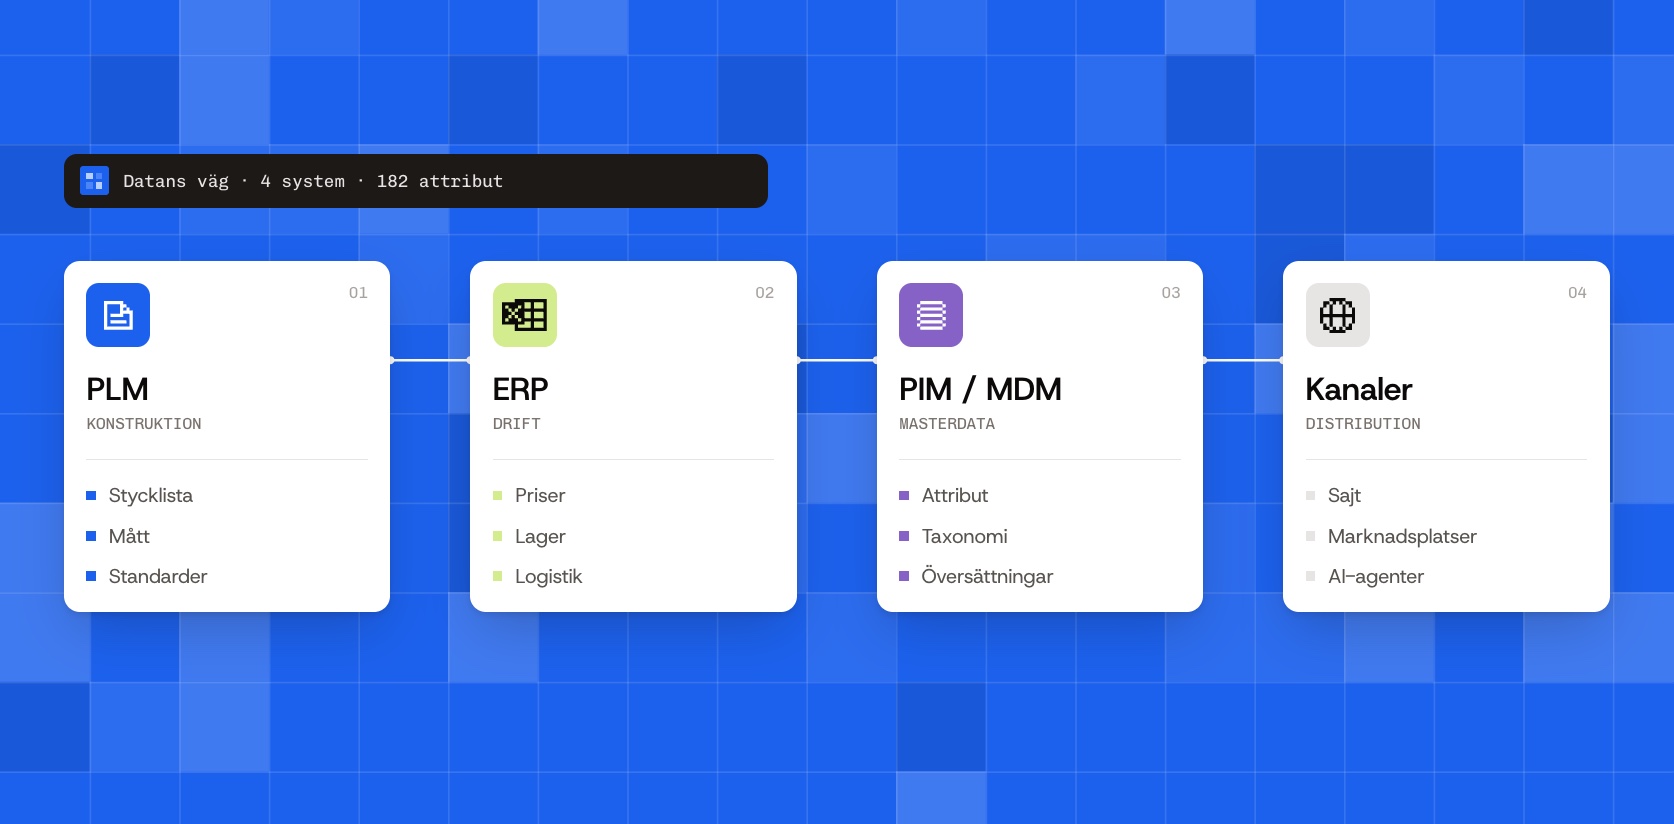
I de flesta organisationer inom e-handel och retail följer produktdatans kedja fyra stora steg, som inte alltid har namn, men som kan sammanfattas så här: PLM, MDM, PIM och sedan publiceringskanalerna, ibland med feed managers före kanalerna
1. PLM: där produktdatan föds
PLM (Product Lifecycle Management) är startpunkten.
Det är där produkten utformas:
FoU, konstruktion, industriella specifikationer, stycklistor, regulatoriska krav, material, mått, standarder.
👉 Datan är där:
- mycket rik
- mycket precis
- men tänkt för industrin, inte för försäljning
I det här skedet finns produkten tekniskt, men den går ännu inte att använda för e-handels- eller marknadsteam.
AI-agenter kan redan här börja spela en diskret men användbar roll: extrahera, strukturera och formulera om komplex teknisk information så att den blir begriplig längre fram i kedjan.
2. MDM: gör datan tillförlitlig och enhetlig
MDM (Master Data Management) är ofta den minst synliga byggstenen… och ändå den mest grundläggande.
Det är datans ryggrad.
Här:
- harmoniseras referensdatan
- rensas dubbletter
- normaliseras attributen
- enhetliggörs enheter, värden och benämningar
- garanteras en enda version av sanningen
Utan ett stabilt MDM tolkar varje system datan på sitt eget sätt.
AI-agenter är särskilt effektiva på den här nivån för att:
- upptäcka inkonsekvenser och avvikelser
- stämma av heterogena källor mot varandra
- automatiskt berika saknade fält
- kontinuerligt kontrollera datakvaliteten
Det är ett nyckelsteg: innan man accelererar med AI måste datan bli tillförlitlig.
3. PIM: gör datan kommersiellt användbar
PIM (Product Information Management) är e-handelns cockpit.
Det är här datan blir:
- beskrivande
- begriplig
- jämförbar
- säljbar
Produktbeskrivningar, marknadsföringsattribut, SEO, översättningar, varianter, regler per kanal…
Det är också här som den operativa belastningen exploderar när katalogerna överstiger några hundra eller till och med tusentals produkter.
AI-agenterna förändrar det här steget på djupet:
- generering av enhetligt innehåll utifrån strukturerad data
- automatisk berikning av attribut och bilder
- anpassning av innehållet efter kanaler, språk eller marknader
- kvalitetskontroller före publicering
Det handlar inte längre bara om att ”producera snabbare”, utan om att hålla kvaliteten i stor skala.
4. Kanaler: där datan konsumeras
Sista steget: kanalerna.
E-handelssajter, marknadsplatser, appar, papperskataloger, partnerflöden… Och nu även berikade sökmotorer och konversationell AI.
Varje kanal ställer:
- sina format
- sina regler
- sina krav på strukturering
På den här nivån:
- omvandlar AI-agenterna datan för varje kanal
- automatiserar de uppdateringen av flödena
- kontrollerar de att kraven uppfylls
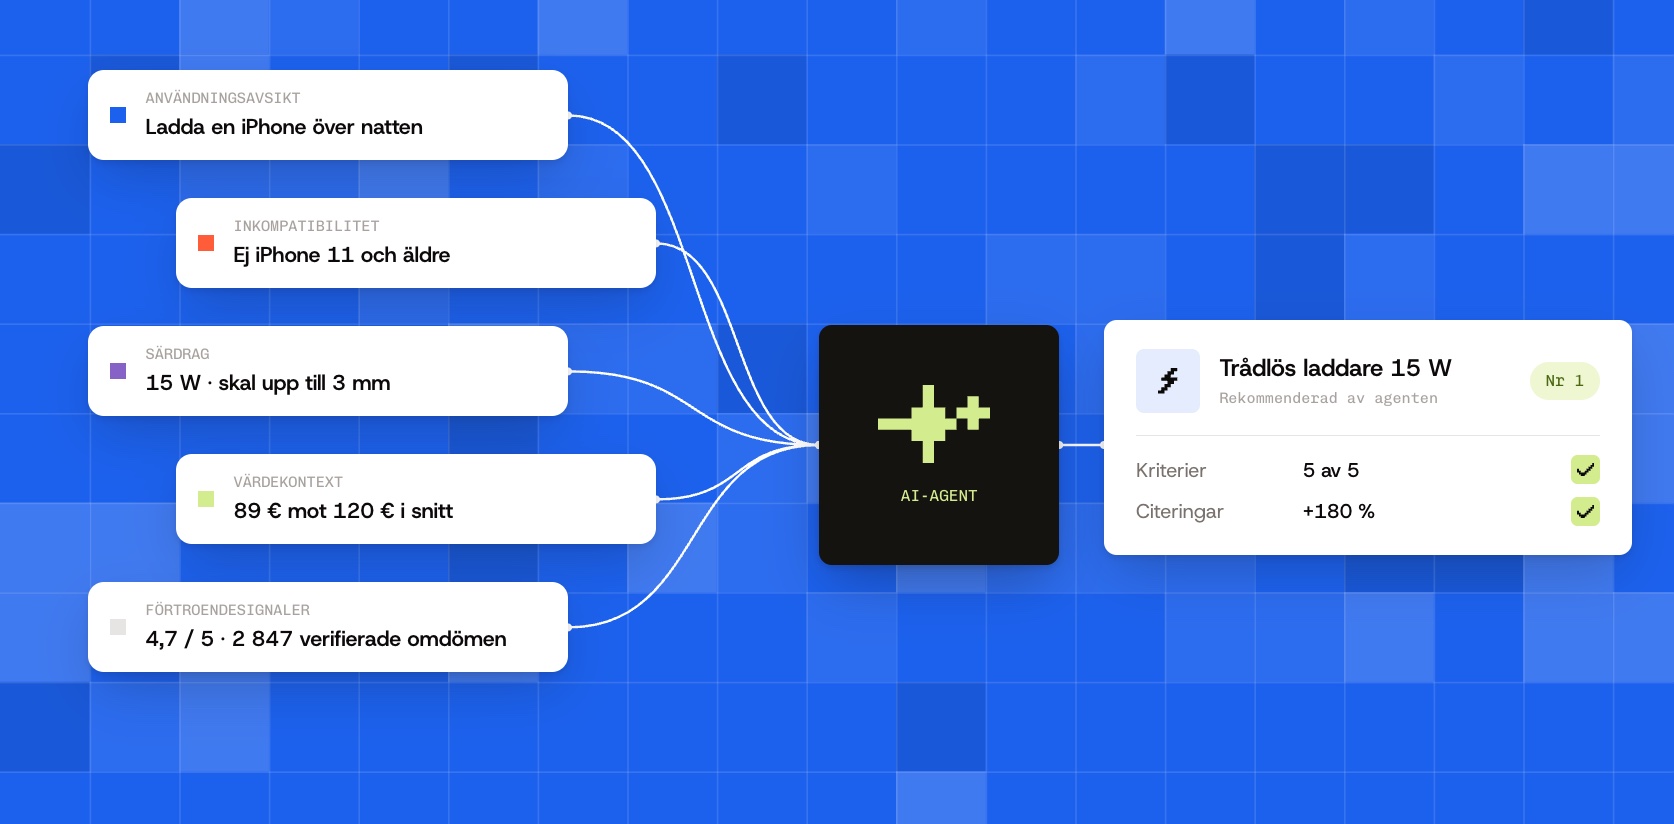
- matar de motorer som kan rekommendera, jämföra och svara på användningsavsikter
👉 Produktdatans kvalitet styr direkt synlighet, konvertering och förtroende.
5. Och var kommer feed managers in?
Mellan PIM och kanalerna förlitar sig i dag många organisationer på feed managers (Channable, Lengow, Feed Manager osv.).
Deras roll är tydlig: att anpassa, omvandla och distribuera produktdatan till en mängd plattformar (marknadsplatser, prisjämförelsetjänster, social handel, partner, annonsnätverk och nu även AI-motorer).
De spelar en nyckelroll för att:
- mappa attributen till de scheman som varje kanal förväntar sig
- tillämpa regler för omvandling och prioritering
- hantera flödesvarianter i stor skala
- upprätthålla en kontinuerlig och kontrollerad publicering
Men feed managers har en strukturell begränsning: de skapar inte datan. De orkestrerar den.
Om indatan är ofullständig, inkonsekvent eller dåligt strukturerad gör feed managern inget annat än att stämma av ungefärligheter.
Det är här samspelet med AI-agenter tidigare i kedjan blir avgörande.
Agenter placerade mellan MDM och PIM, och sedan mellan PIM och feed managers, gör det möjligt att:
- berika attributen före distribution
- göra nyckelvärdena tillförlitliga (enheter, kompatibilitet, användningsområden)
- förbereda ”AI-redo” flöden som är enhetliga och användbara för alla kanaler
I en värld där kanalerna blir fler och AI-motorerna själva blir konsumenter av flöden är feed managern fortfarande oumbärlig, men den är mer än någonsin beroende av kvaliteten på datan längre upp i kedjan.
👉 Resultatet avgörs inte längre i den slutliga omvandlingen, utan i förmågan att leverera ren, strukturerad och genomtänkt data före publiceringen.
Sammanfattning: en sammanhängande kedja, inte silor
Kartläggningen kan sammanfattas enkelt:
- PLM: tillverka produkten
- MDM: göra datan tillförlitlig
- PIM: lyfta fram produkten
- Kanaler (med eller utan feed managers): publicera och sälja
Det AI avslöjar i dag är att produktdatan har blivit den främsta begränsande faktorn för e-handelns resultat.
AI-agenterna ersätter inte dessa byggstenar.
De går igenom dem.
De kopplar ihop dem.
Och framför allt gör de deras svagheter omedelbart synliga.
Den verkliga frågan är alltså inte längre bara teknisk.
👉 Var befinner sig din produktdata i den här kedjan?
👉 Och vid vilken punkt blir den en hävstång… eller en broms?
Det är på det villkoret som AI verkligen kan skapa värde, varaktigt.
 Marcus




 Amazon