



Kortlægning af produktdata: forstå produktdataenes vej
Når man taler om “produktdata”, får man ofte indtryk af, at det drejer sig om én samlet blok.
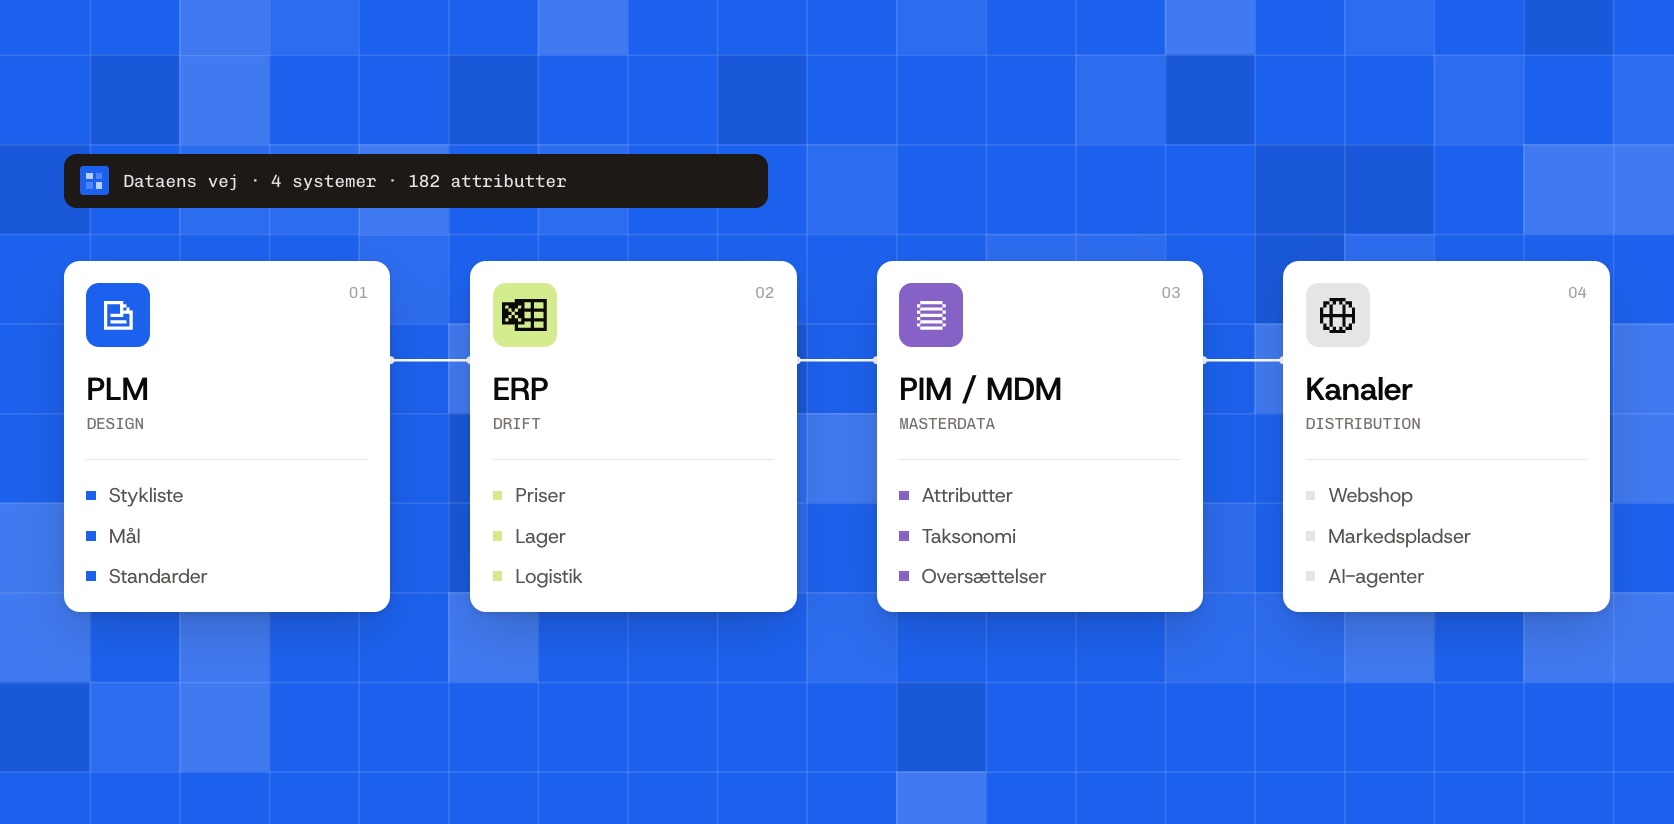
Når man taler om “produktdata”, får man ofte indtryk af, at det drejer sig om én samlet blok. I virkeligheden er produktdata et flow, der går gennem flere systemer, flere faggrupper og flere modenhedsniveauer, før det når frem til kunden.
For at forstå, hvor friktionen opstår, og hvor AI for alvor ændrer spillereglerne, skal man først kortlægge denne rejse.
I de fleste organisationer inden for e-handel og retail følger produktdataenes kæde fire store trin, som ikke altid bliver navngivet, men som kan opsummeres sådan: PLM, MDM, PIM og derefter udgivelseskanalerne, nogle gange med feed managers indskudt før kanalerne
1. PLM: hvor produktdata bliver født
PLM (Product Lifecycle Management) er udgangspunktet.
Det er her, produktet bliver udviklet:
R&D, engineering, industrielle specifikationer, styklister, lovkrav, materialer, mål, standarder.
👉 Dataene er her:
- meget rige
- meget præcise
- men tænkt til produktion, ikke til salg
På dette stadie eksisterer produktet teknisk, men det kan endnu ikke bruges af e-handels- eller marketingteams.
AI-agenter kan allerede her begynde at spille en diskret, men nyttig rolle: udtrække, strukturere og omformulere kompleks teknisk information, så den bliver forståelig længere nede i kæden.
2. MDM: gør data pålidelige og ensartede
MDM (Master Data Management) er ofte den mindst synlige byggesten… og alligevel den mest strukturerende.
Det er dataenes rygrad.
Her:
- harmoniserer man referencedataene
- fjerner man dubletter
- standardiserer man attributterne
- ensretter man enheder, værdier og betegnelser
- sikrer man én enkelt version af sandheden
Uden et solidt MDM fortolker hvert system dataene på sin egen måde.
AI-agenter er særligt effektive på dette niveau til at:
- finde uoverensstemmelser og afvigelser
- afstemme uensartede kilder
- automatisk berige manglende felter
- løbende kontrollere datakvaliteten
Det er et nøgletrin: før man accelererer med AI, skal dataene gøres pålidelige.
3. PIM: gør data kommercielt brugbare
PIM (Product Information Management) er e-handlens cockpit.
Det er her, dataene bliver:
- beskrivende
- forståelige
- sammenlignelige
- salgbare
Produktbeskrivelser, marketingattributter, SEO, oversættelser, varianter, regler pr. kanal…
Det er også her, den operationelle byrde eksploderer, når katalogerne overstiger nogle hundrede eller endda tusinder af produkter.
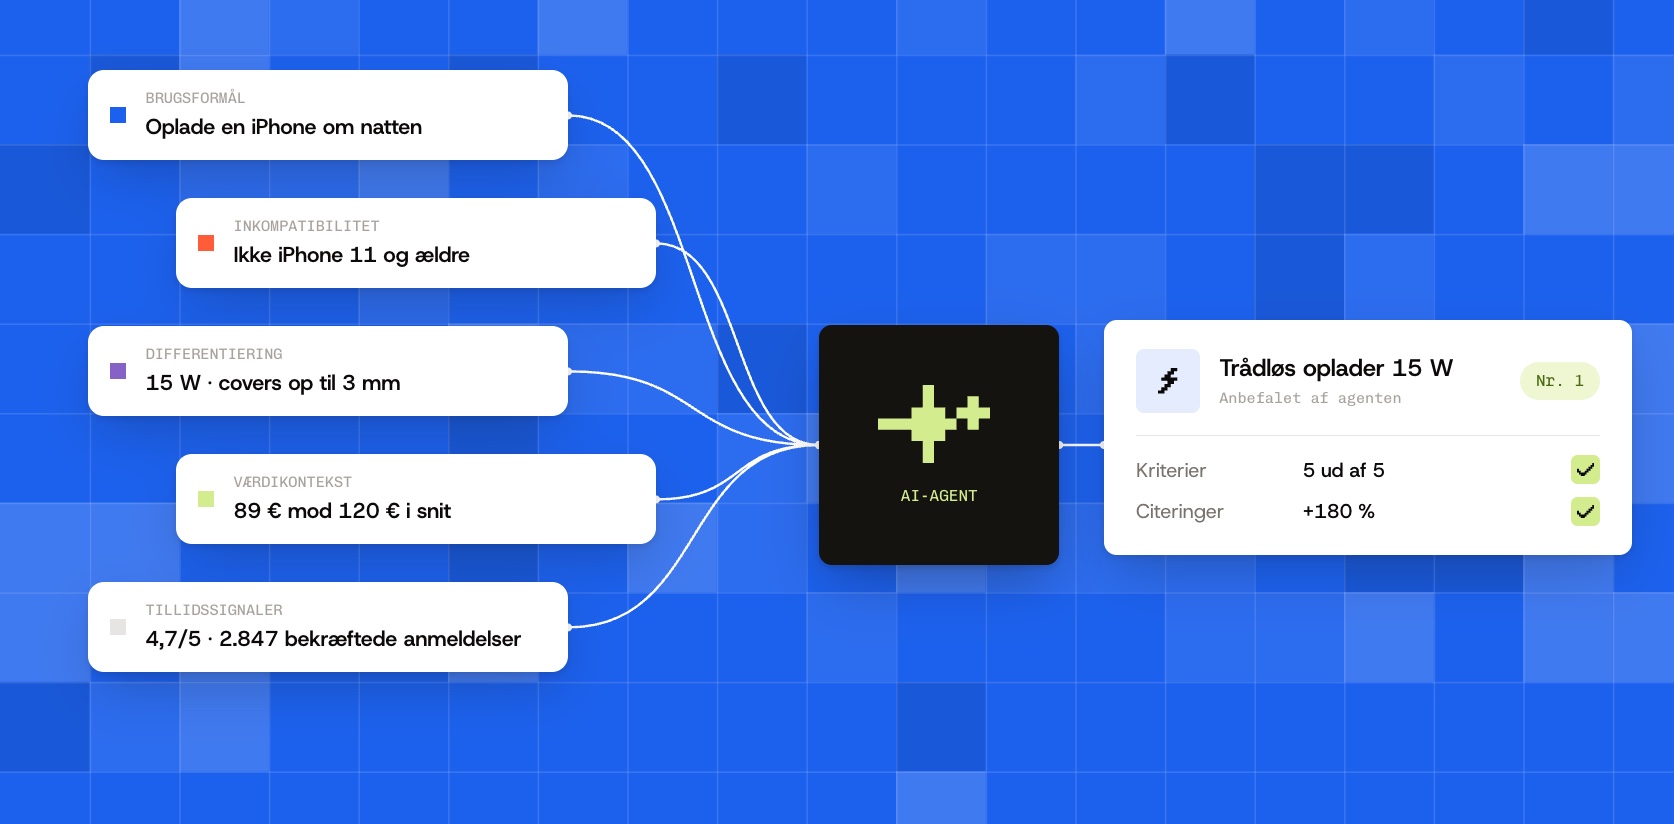
AI-agenterne forandrer dette trin grundlæggende:
- generering af sammenhængende indhold ud fra strukturerede data
- automatisk berigelse af attributter og billeder
- tilpasning af indholdet efter kanal, sprog eller marked
- kvalitetskontrol før udgivelse
Det handler ikke længere kun om at “producere hurtigere”, men om at fastholde kvaliteten i stor skala.
4. Kanaler: hvor data bliver brugt
Sidste trin: kanalerne.
Webshops, markedspladser, apps, papirkataloger, partnerfeeds… Og nu også berigede søgemaskiner og konversationel AI.
Hver kanal stiller krav om:
- sine formater
- sine regler
- sine krav til strukturering
På dette niveau:
- omformer AI-agenterne dataene til hver kanal
- automatiserer de opdateringen af feeds
- kontrollerer de overholdelsen af kravene
- fodrer de motorer, der kan anbefale, sammenligne og svare på brugshensigter
👉 Produktdataenes kvalitet er direkte afgørende for synlighed, konvertering og tillid.
5. Og hvor kommer feed managers ind i billedet?
Mellem PIM og kanalerne støtter mange organisationer sig i dag til feed managers (Channable, Lengow, Feed Manager osv.).
Deres rolle er klar: at tilpasse, omforme og distribuere produktdata til et væld af platforme: markedspladser, prissammenligningstjenester, social commerce, partnere, annoncenetværk og nu også AI-motorer.
De spiller en nøglerolle i at:
- mappe attributterne til de skemaer, hver kanal forventer
- anvende regler for omformning og prioritering
- håndtere varianter af feeds i stor skala
- opretholde en kontinuerlig og kontrolleret udgivelse
Men feed managers har en strukturel begrænsning: de skaber ikke data. De orkestrerer dem.
Hvis de indgående data er ufuldstændige, inkonsistente eller dårligt strukturerede, gør feed manageren ikke andet end at forlige tilnærmelser.
Det er her, samspillet med AI-agenter tidligere i kæden bliver afgørende.
Agenter placeret mellem MDM og PIM og derefter mellem PIM og feed managers gør det muligt at:
- berige attributterne før distributionen
- gøre nøgleværdierne pålidelige (enheder, kompatibilitet, anvendelser)
- forberede “AI-ready” feeds, der er sammenhængende og kan bruges af alle kanaler
I en verden, hvor kanalerne bliver flere, og hvor AI-motorerne selv bliver forbrugere af feeds, er feed manageren fortsat uundværlig, men den afhænger mere end nogensinde af kvaliteten af dataene længere oppe i kæden.
👉 Performance afgøres ikke længere i den endelige omformning, men i evnen til at levere rene, strukturerede og målrettede data før udgivelsen.
Opsummering: en sammenhængende kæde, ikke siloer
Kortlægningen kan opsummeres enkelt:
- PLM: fremstil produktet
- MDM: gør dataene pålidelige
- PIM: fremhæv produktet
- Kanaler (med eller uden feed managers): udgiv og sælg
Det, AI afslører i dag, er, at produktdata er blevet den vigtigste begrænsende faktor for performance i e-handlen.
AI-agenterne erstatter ikke disse byggesten.
De går på tværs af dem.
De forbinder dem.
Og frem for alt gør de deres svagheder synlige med det samme.
Det egentlige spørgsmål er altså ikke længere kun teknologisk.
👉 Hvor befinder dine produktdata sig i denne kæde?
👉 Og hvornår bliver de en løftestang… eller en bremse?
Det er på den betingelse, at AI for alvor kan skabe værdi, og varigt.
 Marcus




 Amazon